
Redis入门
Redis入门
1. Redis 简介
Redis 是一个开源的使用 ANSI C 语言编写、支持网络、可基于内存亦可持久化的日志型、Key-Value 数据库,并提供多种语言的 API。
简单来说 Redis 是一种键值对(key-value)高性能缓存数据库,类似于 Java 中的 Map<key, value>,可以用来减轻关系型数据库(MySQL、Oracle...)的压力。
Redis 安装查看 Linux安装Redis,可执行文件作用如下。
| 可执行文件 | 启动 Redis |
|---|---|
| redis-server | 启动 Redis |
| redis-cli | redis 命令行客户端 |
| redis-benchmark | 基准测试工具 |
| redis-check-aof | AOF 持久化文件检测和修复工具 |
| redis-check-dump/redis-check-rdb | RDB 持久化文件检测和修复工具 |
| redis-sentinel | 启动哨兵 |
停止 redis 服务:redis-cli shutdown
- 关闭时,断开连接,持久化文件生成,相对安全。
- 使用 kill 方式关闭进程时,不会做持久化,还会造成缓冲区非法关闭,会导致数据丢失。
- 关闭前持久化文件,登录 redis-cli 客户端,再
shutdown nosave|save。
2. 常用数据结构
Redis 7 核心数据结构分为核心版(Core)与扩展版(Modules)。核心版是开箱即用的 9 种数据类型,扩展版需加载对应模块。
| 数据类型 | 说明 |
|---|---|
| String | 字符串 |
| Hash | 哈希 |
| List | 列表 |
| Set | 集合 |
| Sorted Set(ZSet) | 有序集合 |
| Bitmap | 位图 |
| HyperLogLog | 基数统计 |
| Geo | 地理位置 |
| Stream | 流 |
扩展版(Modules)还包括 Stack、Bloom filter、Count-min sketch、JSON、Search and query、Time series、Top-K 等。当然最常用的还是前五个(String,Hash,List,Set,ZSet)。
小技巧:在 redis-cli 中可通过 help 快速查询命令:
help @<group>    # 查看某个命令组的命令列表
help <command>   # 查看某个命令的帮助
help <tab>       # 列出所有可能的帮助主题
quit             # 退出
3. String
String 是 Redis 最基本的数据类型,二进制安全的字符串,最大可存储 512MB。
3.1 常用操作
SET key value                  # 存入字符串键值对
MSET key value [key value ...] # 批量存储字符串键值对
SETNX key value                # 存入一个不存在的字符串键值对
GET key                        # 获取一个字符串键值
MGET key [key ...]             # 批量获取字符串键值
DEL key [key ...]              # 删除一个键
EXPIRE key seconds             # 设置一个键的过期时间(秒)
3.2 原子加减
INCR key              # 将 key 中储存的数字值加 1
DECR key              # 将 key 中储存的数字值减 1
INCRBY key increment  # 将 key 所储存的值加上 increment
DECRBY key decrement  # 将 key 所储存的值减去 decrement
3.3 应用场景
单值缓存
SET key value
APPEND key value
对象缓存
# 方式一:JSON 字符串整体存储
SET user:1 '{"name":"zhangsan","age":18}'

# 方式二:多 key 拆分存储
MSET user:1:name zhangsan user:1:age 18
MGET user:1:name user:1:age
分布式锁
SETNX product:10001 true   # 返回 1 代表获取锁成功
SETNX product:10001 true   # 返回 0 代表获取锁失败
# ...执行业务操作
DEL product:10001          # 执行完业务释放锁
SET product:10001 true ex 10 nx   # 防止程序意外终止导致死锁(原子性)
4. Hash
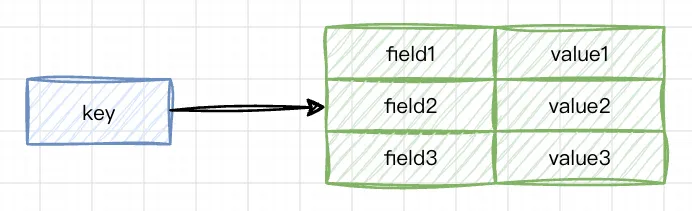
Hash 是一个键值对集合,适合存储对象,结构为 key -> field -> value。
4.1 常用操作
HSET key field value                      # 存储一个哈希表 key 的键值
HSETNX key field value                    # 存储一个不存在的哈希表 key 的键值
HMSET key field value [field value ...]   # 在一个哈希表 key 中存储多个键值对(Redis 4+ 可用 HSET 替代)
HGET key field                            # 获取哈希表 key 对应的 field 键值
HMGET key field [field ...]               # 批量获取哈希表 key 中多个 field 键值
HDEL key field [field ...]                # 删除哈希表 key 中的 field 键值
HLEN key                                  # 返回哈希表 key 中 field 的数量
HGETALL key                               # 返回哈希表 key 中所有的键值
HINCRBY key field increment               # 为哈希表 key 中 field 键的值加上增量 increment
4.2 应用场景
对象缓存
HSET user:1 name zhangsan age 18
HMGET user:1 name age

# 也可以按字段拆分存储
HSET user 1:name zhangsan 1:age 18
HMGET user 1:name 1:age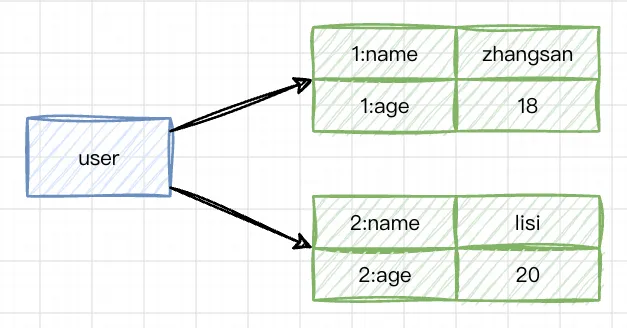
电商购物车
以用户 id 为 key,商品 id 为 field,商品数量为 value。
# 购物车操作
1) 添加商品           -> HSET cart:1001 10088 1
2) 增加数量           -> HINCRBY cart:1001 10088 1
3) 商品总数           -> HLEN cart:1001
4) 删除商品           -> HDEL cart:1001 10088
5) 获取购物车所有商品 -> HGETALL cart:1001
和 String 对比
优点:
- 同类数据归类整合储存,方便数据管理。
- 相比 String 操作消耗内存与 CPU 更小。
- 相比 String 储存更节省空间。
缺点:
- 过期功能不能使用在 field 上,只能用在 key 上。
- Redis 集群架构下不适合大规模使用。
5. List
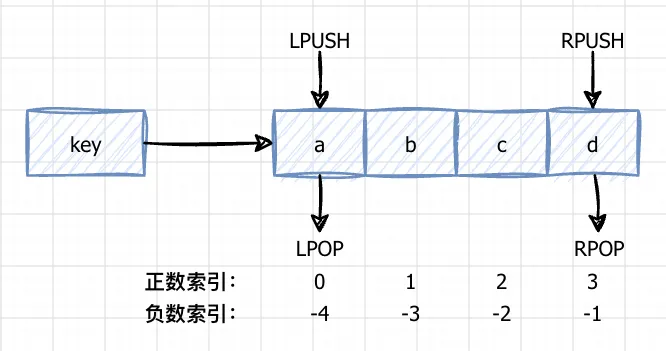
List 是简单的字符串列表,按照插入顺序排序,可从两端插入,底层为双向链表。
5.1 常用操作
LPUSH key value [value ...]         # 将一个或多个值插入到列表表头(最左边)
RPUSH key value [value ...]         # 将一个或多个值插入到列表表尾(最右边)
LPOP key                            # 移除并返回列表的头元素
RPOP key                            # 移除并返回列表的尾元素
LRANGE key start stop               # 返回列表指定区间内的元素
BLPOP key [key ...] timeout         # 从表头弹出元素,若无元素则阻塞等待 timeout 秒,0 表示一直阻塞
BRPOP key [key ...] timeout         # 从表尾弹出元素,若无元素则阻塞等待 timeout 秒,0 表示一直阻塞
5.2 应用场景
| 结构 | 组合 |
|---|---|
| Stack(栈) | LPUSH + LPOP |
| Queue(队列) | LPUSH + RPOP |
| Blocking MQ(阻塞队列) | LPUSH + BRPOP |
常见场景:视频列表、签到列表、排队机、简化版 MQ。
公众号发布消息时,向订阅本公众号的用户(mess:1)推送(将订阅消息 id 通过 lpush 放入用户的 list 中)。
模拟过程
// 推送消息
lpush mess:1 999
lpush mess:1 1000
lpush mess:1 1010

// 查看消息,返回结果1010 1000 999
lrange mess:1 0 -1
注意
- 一个 List 的容量为 2^32 - 1,约 40 多亿,但要注意大 key 问题。
- 底层为双向链表,对两端操作性能很高,但通过索引下标操作中间节点性能较低。
6. Set
Set 是 String 类型的无序集合,元素唯一、自动去重。
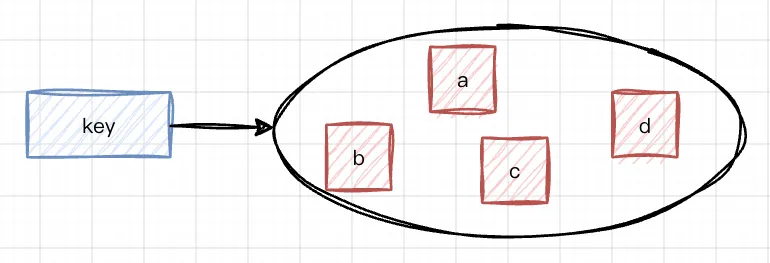
6.1 常用操作
SADD key member [member ...]   # 往集合中存入元素,元素存在则忽略
SREM key member [member ...]   # 从集合中删除元素
SMEMBERS key                   # 获取集合中所有元素
SCARD key                      # 获取集合的元素个数
SISMEMBER key member           # 判断元素是否存在于集合中
SRANDMEMBER key [count]        # 从集合中随机选出 count 个元素,不删除
SPOP key [count]               # 从集合中随机选出 count 个元素并删除

SINTER key [key ...]                     # 交集运算
SINTERSTORE destination key [key ...]    # 将交集结果存入新集合
SUNION key [key ...]                     # 并集运算
SUNIONSTORE destination key [key ...]    # 将并集结果存入新集合
SDIFF key [key ...]                      # 差集运算
SDIFFSTORE destination key [key ...]     # 将差集结果存入新集合
6.2 应用场景
微信抽奖小程序
1) 点击参与抽奖加入集合  SADD key {userID}
2) 查看参与抽奖所有用户  SMEMBERS key
3) 抽取 count 名中奖者  SRANDMEMBER key [count] / SPOP key [count]
点赞、收藏、标签
1) 点赞                SADD like:{消息ID} {用户ID}
2) 取消点赞            SREM like:{消息ID} {用户ID}
3) 检查用户是否点过赞  SISMEMBER like:{消息ID} {用户ID}
4) 获取点赞的用户列表  SMEMBERS like:{消息ID}
5) 获取点赞用户数      SCARD like:{消息ID}
共同关注、推荐好友
SINTER set1 set2 set3 -> { c }           # 共同关注的人
SUNION set1 set2 set3 -> { a,b,c,d,e }   # 朋友圈的人
SDIFF  set1 set2 set3 -> { a }           # 推荐好友
7. ZSet
ZSet(Sorted Set)是有序集合,每个元素关联一个 score,按 score 排序,score 可重复但 member 唯一。
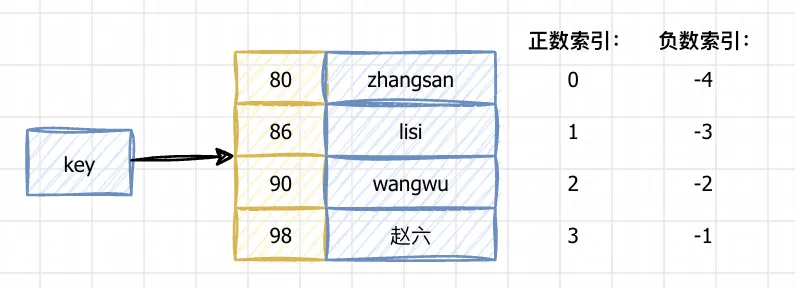
7.1 常用操作
ZADD key score member [[score member]...]     # 往有序集合中加入带分值元素
ZREM key member [member ...]                  # 从有序集合中删除元素
ZSCORE key member                             # 返回有序集合中元素的分值
ZINCRBY key increment member                  # 为有序集合中元素的分值加上增量
ZCARD key                                     # 返回有序集合中元素个数
ZRANGE key start stop [WITHSCORES]            # 正序获取指定区间的元素
ZREVRANGE key start stop [WITHSCORES]         # 倒序获取指定区间的元素

ZUNIONSTORE destkey numkeys key [key ...]   # 并集计算
ZINTERSTORE destkey numkeys key [key ...]   # 交集计算
7.2 应用场景
各种榜单,例如百度新闻排名,将新闻 id 作为 member,点击次数设置为 score,每点击一次 score+1,当然,为了每日榜单,member 在设计时可以加上后缀用于日期区分,例如 news:20191216、news:20191217。
// 增加热点新闻
zadd topic:20191216 100 new:1 200 new:2 150 new:3 500 new:4

// new:1点击了120次,点击数变为220
zincrby topic:20191216 120 new:1

// 查看今日排行前3名,返回 new:4 500 new:1 220 new:2 200
zrevrange topic:20191216 0 2 withscores

zadd topic:20191217 110 new:1 200 new:2 150 new:3 100 new:4
zadd topic:20191218 110 new:5 200 new:2 150 new:6 100 new:7
// 合并三日的数据
zunionstore topic:3day 3 topic:20191216 topic:20191217 topic:20191218
// 查看近三日排行榜前三名,返回new:4 600 new:2 600 new:1 330
zrevrange topic:3day 0 2 withscores
8. Bitmap
Bitmap 是位图,用 String 类型作为底层,一个 bit 位对应一个偏移量,适合二值状态统计。
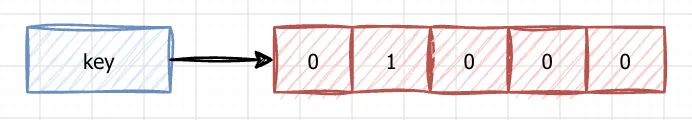
8.1 常用操作
SETBIT key offset value   # 将二进制数组 offset 位置设为 value(0/1)
GETBIT key offset         # 返回二进制数组 offset 位置的值
BITCOUNT key [start end [BYTE|BIT]]   # 返回二进制数组中 1 的个数
BITPOS key bit [start [end [BYTE|BIT]]]  # 返回 bitmap 中第一个值为 bit 的 offset
BITOP AND|OR|XOR|NOT destkey key [key ...]  # 对 bitmap 做与或非运算
8.2 应用场景
每日签到
SETBIT dailycheck:1 100 1   # 1 号用户第 100 天完成签到
BITCOUNT dailycheck:1       # 统计 1 号用户的签到次数
BITPOS dailycheck:1 1       # 查询 1 号用户第一次签到的偏移量
优点:快速、高效、节省空间,1 亿用户签到数据仅约 12MB。
9. HyperLogLog
用于统计集合中不重复元素个数(基数统计),适用于 UV 统计,误差约 0.81%,极省内存(12KB 可统计 2^64 个元素)。
9.1 常用操作
PFADD visitlog 192.168.1.111 192.168.1.112 192.168.1.111   # 添加用户访问记录
PFCOUNT visitlog                                              # 统计独立访客数
PFMERGE destkey [sourcekey ...]   # 将多个 HyperLogLog 合并
典型场景:根据用户访问记录统计网站 UV,或多天 UV 合并。
10. Geo
Geo 是基于 ZSet 实现的地理位置数据类型,支持存储经纬度、计算距离、附近搜索。
10.1 常用操作
GEOADD key [NX|XX] [CH] longitude latitude member [longitude latitude member ...] # 添加一个或多个地点

GEOPOS key [member ...] # 返回地点的经纬度

GEODIST key member1 member2 [M|KM|FT|MI] # 计算两个地点之间的距离

GEORADIUS key longitude latitude radius M|KM|FT|MI [WITHCOORD] [WITHDIST] [WITHHASH]
           [COUNT count [ANY]] [ASC|DESC] [STORE key | STOREDIST key] # 查询某个经纬度附近的地点(Redis 6.2 起可用 GEOSEARCH 替代)

GEOSEARCH key FROMMEMBER member | FROMLONLAT longitude latitude
           BYRADIUS radius M|KM|FT|MI | BYBOX width height M|KM|FT|MI
           [ASC|DESC] [COUNT count [ANY]] [WITHCOORD] [WITHDIST] [WITHHASH] # 查询某个地点附近的地点
10.2 应用场景
存储经纬度、计算距离、附近搜索。
添加商家地址
GEOADD changsha 113.017489 28.200454 火车站
                112.96903 28.201195 橘子洲
                113.017031 28.199706 赛格广场
                113.017004 28.197677 国储
查询距离
GEODIST changsha 火车站 橘子洲 M查找附近景点
GEOSEARCH changsha FROMMEMBER 火车站 BYRADIUS 2 KM WITHDIST WITHCOORD COUNT 4
# 旧版写法:GEORADIUSBYMEMBER changsha 火车站 2 KM WITHDIST WITHCOORD COUNT 4 WITHHASH
11. Stream
Stream 是 Redis 5.0 引入的流数据类型,相当于阻塞队列 + Pub/Sub,支持消息持久化与消费者组,是 Redis 版的 MQ,了解即可,企业中通常使用专门的 MQ。
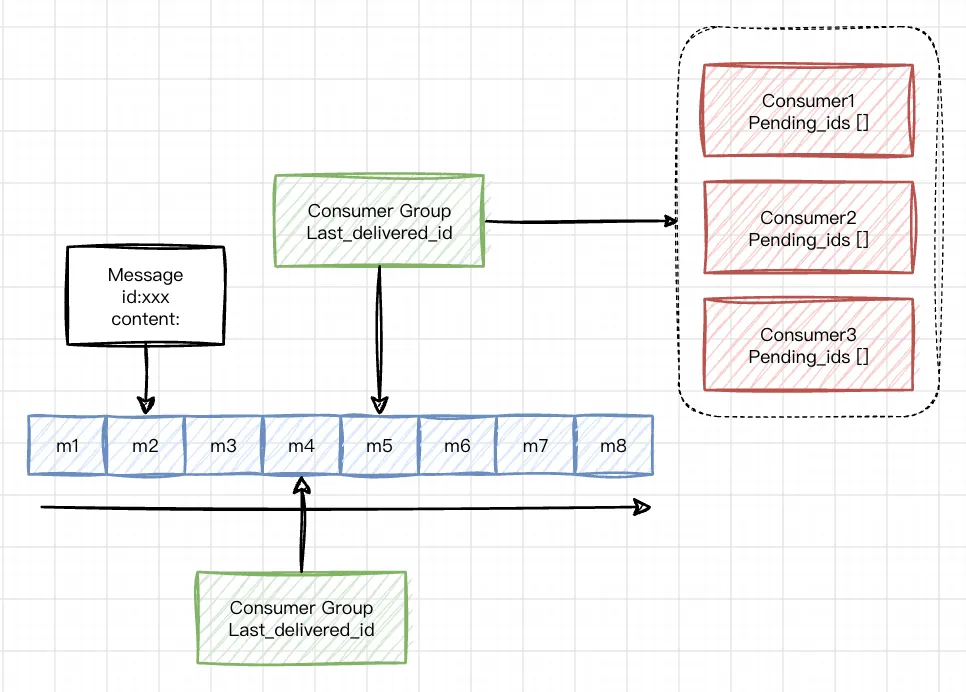
Stream 包含以下几个关键概念:
- 消息(Message):流中的基本单元,每条消息由一个唯一 ID 和一组键值对(Field-Value)组成,可以存储结构化的数据。
- 消息 ID(Entry ID):格式为
<毫秒时间戳>-<序号>,例如1715000000000-1。- 时间戳部分由服务器本地时间生成,保证了消息的时序性。
- 序号用于区分同一毫秒内产生的多条消息,从 0 开始递增。
- ID 是全局唯一且单调递增的,这天然保证了消息的有序性。
- 消费者组(Consumer Group):这是 Stream 实现多播和负载均衡的核心机制。
- 一个 Stream 可以挂载多个消费者组,每个组都拥有独立的消费进度(
last_delivered_id),互不影响。这意味着每个组都能消费到 Stream 中的全部消息。 - 每个消费者组内可以包含多个消费者(Consumer),它们之间是竞争关系,Stream 中的每条消息只会被组内的一个消费者处理,从而实现并行消费。
- 一个 Stream 可以挂载多个消费者组,每个组都拥有独立的消费进度(
- 待处理列表(Pending Entries List, PEL):每个消费者内部都维护着一个 PEL。它记录了已被消费者读取,但尚未确认(ACK)的消息 ID。这是实现消息至少一次(At-least-once)消费保障的关键,确保在网络故障或消费者崩溃后,消息可以被重新处理。
11.1 常用操作
# ① 添加消息(field value 为消息内容,一条消息可携带多组键值对)
XADD key [NOMKSTREAM] [MAXLEN|MINID [=|~] threshold [LIMIT count]] *|id field value [field value ...]
#   *          自动生成消息 ID,格式为 <毫秒时间戳>-<序号>
#   id         手动指定消息 ID,必须大于当前流中最大的 ID
#   NOMKSTREAM 流不存在时不自动创建,直接返回 nil
#   MAXLEN     消息数量超过 threshold 时裁剪最旧的(保留最新)
#   MINID      删除 ID 小于 threshold 的消息
#   = / ~      = 精确裁剪(默认);~ 近似裁剪,性能高但长度不精确
#   LIMIT      配合 ~ 使用时,限制单次裁剪的条数
# ② 查看与删除
XRANGE key start end [COUNT count] # 正序查询区间内消息;start/end 为消息 ID,- 表示最老,+ 表示最新
XREVRANGE key end start [COUNT count] # 倒序查询,start/end 顺序与 XRANGE 相反
XLEN key # 返回消息总数
XDEL key id [id ...] # 按 ID 删除一条或多条消息
XTRIM key MAXLEN|MINID [=|~] threshold # 裁剪消息:MAXLEN 保留最新 threshold 条;MINID 删除 ID 小于 threshold 的# ③ 独立消费者(阻塞读取,不使用消费者组)
XREAD [COUNT count] [BLOCK milliseconds] STREAMS key [key ...] id [id ...]
# COUNT 最多读取 count 条消息
# BLOCK 无消息时阻塞等待 milliseconds 毫秒,0 表示一直阻塞
# STREAMS 后跟流名及各自起始 ID;0 表示从头读取,$ 表示只读取之后新出现的消息# ④ 消费者组
XGROUP CREATE key group id|$ [MKSTREAM] # 创建消费者组;id 传 0 从头消费已有消息,传 $ 只接收新消息
XREADGROUP GROUP group consumer [COUNT count] [BLOCK milliseconds] [NOACK] STREAMS key >
# GROUP 指定组名和消费者名,消费者不存在时自动创建
# > 读取组内尚未被消费的新消息;传 0 则读取自己 PEL 中未确认的历史消息
# NOACK 读取后不放入 PEL,无需 ACK
XACK key group id [id ...] # 确认消息已处理,将其从 PEL 中移除
XPENDING key group [start end [COUNT count]] # 查看待确认消息,不带区间参数时返回统计概要
XAUTOCLAIM key group consumer min-idle-time start [COUNT count] # 认领被阻塞超过 min-idle-time 毫秒仍未确认的消息11.2 应用示例
# ===== 1. 生产者:向 mystream 发布 3 条消息,XADD 返回自动生成的 ID =====
XADD mystream * name loulan
# 1715000000000-0

XADD mystream * name zhangsan
# 1715000000000-1

XADD mystream * name admin
# 1715000000000-2

# ===== 2. 查看队列中的全部消息(- 表示最老,+ 表示最新)=====
XRANGE mystream - +
# 1) 1715000000000-0 -> {"name":"loulan"}
# 2) 1715000000000-1 -> {"name":"zhangsan"}
# 3) 1715000000000-2 -> {"name":"admin"}

# ===== 3. 创建消费者组 groupA,0 表示从头开始消费已有消息 =====
XGROUP CREATE mystream groupA 0

# ===== 4. consumer1 一次读取 2 条(> 表示读取组内尚未被消费的新消息)=====
XREADGROUP GROUP groupA consumer1 COUNT 2 STREAMS mystream >
# 1) 1715000000000-0 -> {"name":"loulan"}
# 2) 1715000000000-1 -> {"name":"zhangsan"}

# ===== 5. 查看待确认消息:已读取未确认的消息进入 PEL =====
XPENDING mystream groupA
# 1) (integer) 2        待确认消息总数
# 2) 1715000000000-0    最旧待确认消息 ID
# 3) 1715000000000-1    最新待确认消息 ID
# 4) consumer1 持有 2 条待确认

# ===== 6. consumer2 消费剩余 1 条(组内消费者竞争消息,实现并行消费)=====
XREADGROUP GROUP groupA consumer2 COUNT 2 STREAMS mystream >
# 1) 1715000000000-2 -> {"name":"admin"}

# ===== 7. consumer1 确认消息已处理,对应消息从 PEL 中移除 =====
XACK mystream groupA 1715000000000-0 1715000000000-1
# (integer) 2

# 再次查看,仅剩 consumer2 未确认的 1 条
XPENDING mystream groupA
# 1) (integer) 1
12. SpringBoot 集成 Redis
前文介绍的都是 redis-cli 命令行的用法,实际项目中更多是在 SpringBoot 中用 Java 代码操作 Redis。集成的流程可以总结为三步:引入依赖 → 配置连接 → 注入 RedisTemplate 操作,下面分别说明。
12.1 引入依赖
只需引入起步依赖,spring-boot-starter-data-redis 内置了 Lettuce 客户端(SpringBoot 默认的 Redis 客户端),不需要再单独引入:
<dependency>
    <groupId>org.springframework.boot</groupId>
    <artifactId>spring-boot-starter-data-redis</artifactId>
</dependency>
如果要把对象转成 JSON 字符串存储,可以再引入 spring-boot-starter-json,它同时会让 SpringBoot 自动装配出 ObjectMapper。
12.2 连接配置
SpringBoot 3.x 的 Redis 配置前缀为 spring.data.redis(2.x 是 spring.redis),一般只需配置 host / port / password 三项:
spring:
  data:
    redis:
      host: 127.0.0.1   # Redis 服务器地址
      port: 6379        # 端口
      password: 123456  # 密码,没有密码就注释掉或留空
      database: 0       # 默认 db0,可选 0-15
      timeout: 3s       # 连接超时时间
12.3 RedisTemplate 快速上手
注入一个 RedisTemplate<String, Object>,通过 opsForXxx() 拿到各数据类型的操作组,与前文介绍的数据类型一一对应:
@Resource
private RedisTemplate<String, Object> redisTemplate;| 分组方法 | 数据类型 | 常用方法 |
|---|---|---|
opsForValue() | String | set / get / setIfAbsent / increment |
opsForHash() | Hash | put / get / entries / increment |
opsForList() | List | rightPushAll / leftPush / range / size |
opsForSet() | Set | add / members / isMember / remove |
opsForZSet() | ZSet | add / range / reverseRange / score |
opsForGeo() | Geo | add / position / distance |
opsForHyperLogLog() | HyperLogLog | add / size / union |
opsForStream() | Stream | add / read / size |
补充两点:
- Bit 没有独立的
opsForBit():位图基于 String 按位实现,opsForValue()提供setBit / getBit / bitField;bitCount未封装在opsForValue()中,需通过连接层调用(见 12.5 示例); - key 级的通用操作由
RedisTemplate直接提供:hasKey(EXISTS)、delete(DEL)、getExpire(TTL)、expire(EXPIRE)等。
12.4 中文乱码问题
SpringBoot 自动装配的 RedisTemplate 默认使用 JdkSerializationRedisSerializer(Java 原生序列化),存进 Redis 的是带 \xAC\xED... 前缀的二进制字节,在 redis-cli 里看到的就是乱码。解决方式:在配置类中自定义 RedisTemplate,把 key / value / hash 的序列化器全部换成字符串序列化器:
@Configuration
public class RedisConfig {

    @Bean
    public RedisTemplate<String, Object> redisTemplate(RedisConnectionFactory redisConnectionFactory) {
        RedisTemplate<String, Object> redisTemplate = new RedisTemplate<>();
        redisTemplate.setConnectionFactory(redisConnectionFactory);

        StringRedisSerializer stringSerializer = new StringRedisSerializer();
        GenericToStringSerializer<String> toStringSerializer = new GenericToStringSerializer<>(String.class);

        // key 和 hash 的 key / value 用 StringRedisSerializer
        redisTemplate.setKeySerializer(stringSerializer);
        redisTemplate.setHashKeySerializer(stringSerializer);
        redisTemplate.setHashValueSerializer(stringSerializer);
        // value 用 GenericToStringSerializer<String>,存进去是可读的 UTF-8 文本
        redisTemplate.setValueSerializer(toStringSerializer);
        redisTemplate.afterPropertiesSet();
        return redisTemplate;
    }
}
改完之后 key 名在 redis-cli 里直接可见,value 是可读文本,中文不乱码。
注意:字符串序列化器存不了对象,需要先用 Jackson 把对象转成 JSON 字符串再写入(如果想直接存带类型信息的 JSON,可把 value 序列化器换成 GenericJackson2JsonRedisSerializer):
String json = objectMapper.writeValueAsString(user);            // 对象 → JSON 字符串
redisTemplate.opsForValue().set("user:" + user.getId(), json);  // 写入

String stored = (String) redisTemplate.opsForValue().get("user:" + user.getId());
User back = objectMapper.readValue(stored, User.class);         // 反序列化回对象
12.5 API 使用示例
下面按数据类型给出高频用法(对应命令详见前文各小节),代码都基于同一个 RedisTemplate 对象:
// String:分布式锁雏形(SETNX)、带过期写入(SETEX)、自增(INCR)
Boolean lock = redisTemplate.opsForValue().setIfAbsent("lock:order:1", "1");
redisTemplate.opsForValue().set("code", "1234", 10, TimeUnit.SECONDS);
Long count = redisTemplate.opsForValue().increment("visit:count", 1);
// Hash:对象按字段存储,支持部分更新与自增(如购物车数量)
redisTemplate.opsForHash().put("user:1", "name", "张三");
redisTemplate.opsForHash().put("user:1", "age", "20");
Map<Object, Object> user = redisTemplate.opsForHash().entries("user:1"); // HGETALL
Object name = redisTemplate.opsForHash().get("user:1", "name"); // HGET
redisTemplate.opsForHash().increment("user:1", "age", 1); // HINCRBY// List:右进左出,最简单的消息队列
redisTemplate.opsForList().rightPushAll("queue", "a", "b", "c"); // RPUSH
List<Object> list = redisTemplate.opsForList().range("queue", 0, -1); // LRANGE,0 到 -1 全部
Object first = redisTemplate.opsForList().leftPop("queue"); // LPOP 出队// Set:自动去重、判断存在(点赞、标签等)
redisTemplate.opsForSet().add("tags", "java", "redis", "java"); // SADD,重复只算一个
Set<Object> tags = redisTemplate.opsForSet().members("tags"); // SMEMBERS
Boolean has = redisTemplate.opsForSet().isMember("tags", "java"); // SISMEMBER// ZSet:排行榜,按分数倒序取前 N 名
redisTemplate.opsForZSet().add("rank", "alice", 88.5); // ZADD
redisTemplate.opsForZSet().add("rank", "bob", 95.0);
Set<Object> desc = redisTemplate.opsForZSet().reverseRange("rank", 0, -1); // ZREVRANGE// Bit:签到统计(基于 String)
redisTemplate.opsForValue().setBit("sign:202401", 0, true); // SETBIT,第 0 天签到
redisTemplate.opsForValue().setBit("sign:202401", 2, true);
Boolean day2 = redisTemplate.opsForValue().getBit("sign:202401", 2); // GETBIT
// BITCOUNT 统计 1 的个数;opsForValue() 没有 bitCount,需通过 execute 在连接层调用
Long signed = redisTemplate.execute((RedisCallback<Long>) connection ->
connection.bitCount(redisTemplate.getStringSerializer().serialize("sign:202401")));// Geo:存坐标(经度在前)、算距离
redisTemplate.opsForGeo().add("shop", new Point(116.397, 39.909), "beijing"); // GEOADD
redisTemplate.opsForGeo().add("shop", new Point(121.4737, 31.2304), "shanghai"); // GEOADD
Distance d = redisTemplate.opsForGeo().distance("shop", "beijing", "shanghai",
RedisGeoCommands.DistanceUnit.KILOMETERS); // GEODIST// HyperLogLog:UV 基数统计(近似值)
redisTemplate.opsForHyperLogLog().add("uv:20240101", "u1", "u2", "u3", "u1"); // PFADD
Long uv = redisTemplate.opsForHyperLogLog().size("uv:20240101"); // PFCOUNT,结果为 3// Stream:追加消息(XADD)、从 0 读取全部(XREAD)
RecordId id = redisTemplate.opsForStream().add(
StreamRecords.mapBacked(Map.of("name", "张三")).withStreamKey("myStream"));
List<MapRecord<String, Object, Object>> records = redisTemplate.opsForStream()
.read(StreamOffset.create("myStream", ReadOffset.from("0")));// 通用 key 操作
Boolean exists = redisTemplate.hasKey("hello"); // EXISTS
redisTemplate.expire("code", 10, TimeUnit.SECONDS); // EXPIRE
Long ttl = redisTemplate.getExpire("code"); // TTL,-1 表示永不过期
redisTemplate.delete("hello"); // DEL