
IO模型
IO 模型讨论的是一个很朴素的问题:数据要在网络两端来回传输,应用程序到底用什么方式去「收发」这些数据?更具体一点,当 socket 里暂时没有数据时,程序是干等、轮询,还是把这件事交给操作系统,等到有事发生再被通知。
Java 一共支持 3 种网络编程 IO 模式:BIO、NIO、AIO。
Socket 是什么
Socket(套接字)是操作系统提供给应用程序的网络编程接口,是应用层与 TCP/IP 协议栈之间交互的入口。
在 Linux 中一切皆文件,socket 也不例外:调用一次 socket() 系统调用,内核会返回一个文件描述符(fd),后续的 bind、listen、accept、read、write 都围绕这个 fd 展开。所以从程序的角度看,操作一个 socket 和操作一个文件在形式上没有区别,区别只在于这个「文件」背后连接着网络协议栈。
一条 TCP 连接由四元组唯一标识:源 IP、源端口、目的 IP、目的端口。Socket 就是这条连接在程序里的「把手」:通信双方各持有一个 socket,通过它读写同一条字节流。
以 TCP 服务端为例,socket 编程的流程是固定的:
| 步骤 | 服务端 | 客户端 |
|---|---|---|
| ① | socket() 创建套接字 | socket() 创建套接字 |
| ② | bind() 绑定 IP 和端口 | — |
| ③ | listen() 开始监听 | connect() 发起三次握手 |
| ④ | accept() 取出已完成连接的 socket | — |
| ⑤ | read() / write() 收发数据 | read() / write() 收发数据 |
| ⑥ | close() 关闭连接 | close() 关闭连接 |
到了 Java 里,这套系统调用被封装成了更上层的 API:
- BIO 使用
ServerSocket/Socket; - NIO 使用
ServerSocketChannel/SocketChannel。
同一条 TCP 连接,用 Socket 还是 SocketChannel 来操作,取决于选择了哪种 IO 模型。协议层完全一样,差别只在「怎么读写」:BIO 是一个连接配一个线程阻塞地读写,NIO 是用多路复用器同时盯住大量连接。这里也是后面所有内容的分岔点。
短连接和长连接是什么
两种方式是按「连接的生命周期」来划分的:
- 短连接:每次数据交互都新建一条 TCP 连接,用完立刻关闭;
- 长连接:建立一次连接后持续复用,多次数据交互都走同一条连接。
| 对比维度 | 短连接 | 长连接 |
|---|---|---|
| 生命周期 | 一次交互一条连接 | 一次建立,长期复用 |
| 连接开销 | 每次都有三次握手、四次挥手 | 只有首次建立时有开销 |
| 资源占用 | 连接短暂占用,用完释放 | 服务端要长期维护每条连接的状态 |
| 实时性 | 差,服务端无法主动推送 | 好,随时可以推送 |
| 典型场景 | HTTP/1.0、低频内部调用 | HTTP/1.1 keep-alive、数据库连接池、RPC、IM、推送、游戏 |
严格来说,TCP 本身没有「长短连接」的概念,它只是一条连接;所谓长短,是应用层使用它的方式。短连接的优点是简单,缺点是固定开销大:三次握手、四次挥手每次都要来一遍,主动关闭的一方还会进入 TIME-WAIT 并等待 2×MSL。请求量一大,握手挥手的开销和 TIME_WAIT 的堆积就会成为问题——MySQL 短连接引发大量 TIME_WAIT 就是典型案例。
长连接省掉了反复建连的开销,但代价转移到了「连接维护」上:
- 服务端要为每条连接保留状态:fd、缓冲区、会话信息;
- 连接长期空闲时,要靠心跳(应用层心跳或 TCP Keep-Alive)探测掉线、清理僵尸连接;
- 半开连接、断线重连、消息的粘包半包都需要额外处理。
这里有一个关键认识:长连接场景下,连接很多,但同一时刻真正有数据的连接很少,大多数连接都在「闲着」。BIO 一个连接一个线程,意味着要为每条空闲连接保留一个阻塞的线程,成本高得离谱。如何用少量线程盯住大量空闲连接,就是 IO 模型要解决的核心问题。
心跳为什么通常做在应用层
TCP 自带的 Keep-Alive 默认要 2 小时才探测一次,间隔和次数由内核参数控制,粒度太粗;应用层心跳则可以自定义间隔、内容和超时策略,还能顺带做业务层面的存活检测,所以 RPC、IM 这类框架基本都自己实现心跳。
BIO
BIO 是什么
BIO(Blocking IO,阻塞 IO)是最传统的 IO 模型:同步阻塞,一个客户端连接对应一个处理线程。
所谓阻塞,体现在两个地方:
accept():没有客户端连接时,调用线程一直阻塞在这里;read()/write():没有数据可读或缓冲区写满时,调用线程也一直阻塞。
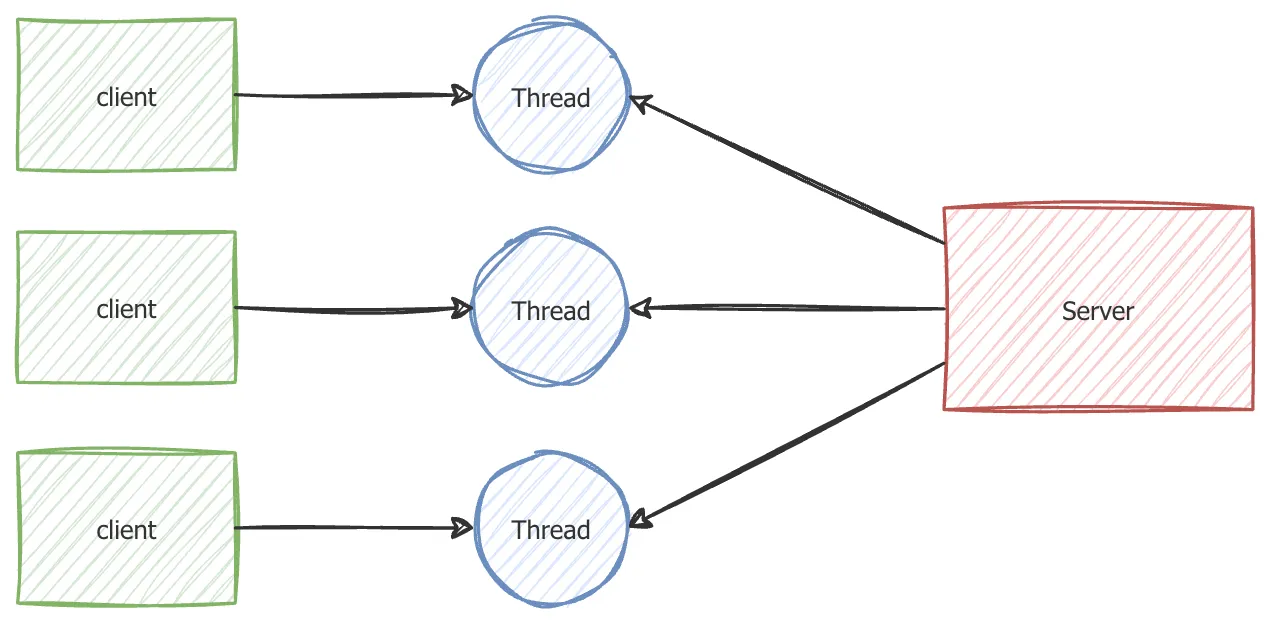
也就是说,BIO 世界里线程和连接是绑定的:只要连接不断开,处理它的线程就没法腾出来干别的事。先看一个最朴素的单线程串行版服务端 SocketServerSingleThread:
package com.juzicoding.bio;

import java.io.IOException;
import java.net.ServerSocket;
import java.net.Socket;

/**
 * 单线程串行版 BIO 服务端:一次只能处理一个客户端连接
 *
 * @author 橘子coding
 */
public class SocketServerSingleThread {

    public static void main(String[] args) throws IOException {
        ServerSocket serverSocket = new ServerSocket(9000);
        while (true) {
            System.out.println("等待连接。。");
            // 阻塞方法:没有客户端连接时,accept 一直阻塞
            Socket clientSocket = serverSocket.accept();
            System.out.println("有客户端连接了。。");
            handler(clientSocket);
        }
    }

    private static void handler(Socket clientSocket) throws IOException {
        byte[] bytes = new byte[1024];
        System.out.println("准备 read。。");
        // 接收客户端的数据,阻塞方法:没有数据可读时就阻塞
        int read = clientSocket.getInputStream().read(bytes);
        System.out.println("read 完毕。。");
        if (read != -1) {
            System.out.println("接收到客户端的数据:" + new String(bytes, 0, read));
        }
        clientSocket.getOutputStream().write("HelloClient".getBytes());
        clientSocket.getOutputStream().flush();
    }
}
这版代码一次只能处理一个客户端:第一个连接不处理完,第二个连接只能在队列里等着。BIO 的标准形态是一连接一线程——把 handler 丢进新线程里执行,主线程立刻回到 accept 等待下一个连接:
package com.juzicoding.bio;

import java.io.IOException;
import java.net.ServerSocket;
import java.net.Socket;

/**
 * BIO 服务端标准形态:一连接一线程
 *
 * @author 橘子coding
 */
public class SocketServer {

    public static void main(String[] args) throws IOException {
        ServerSocket serverSocket = new ServerSocket(9000);
        while (true) {
            System.out.println("等待连接。。");
            // 阻塞方法:没有客户端连接时,accept 一直阻塞
            Socket clientSocket = serverSocket.accept();
            System.out.println("有客户端连接了。。");
            // 每个连接都新建一个线程处理,一连接一线程
            new Thread(() -> {
                try {
                    handler(clientSocket);
                } catch (IOException e) {
                    e.printStackTrace();
                }
            }).start();
        }
    }

    private static void handler(Socket clientSocket) throws IOException {
        byte[] bytes = new byte[1024];
        System.out.println("准备 read。。");
        // 接收客户端的数据,阻塞方法:没有数据可读时就阻塞
        int read = clientSocket.getInputStream().read(bytes);
        System.out.println("read 完毕。。");
        if (read != -1) {
            System.out.println("接收到客户端的数据:" + new String(bytes, 0, read));
        }
        clientSocket.getOutputStream().write("HelloClient".getBytes());
        clientSocket.getOutputStream().flush();
    }
}
客户端代码(后面 NIO 的示例也复用这个客户端):
package com.juzicoding.bio;

import java.io.IOException;
import java.net.Socket;

/**
 * BIO 示例客户端:发送数据后等待服务端回写响应(NIO 服务端不回写,见 SocketClientNoReply)
 *
 * @author 橘子coding
 */
public class SocketClient {

    public static void main(String[] args) throws IOException {
        Socket socket = new Socket("localhost", 9000);
        // 向服务端发送数据
        socket.getOutputStream().write("HelloServer".getBytes());
        socket.getOutputStream().flush();
        System.out.println("向服务端发送数据结束");
        byte[] bytes = new byte[1024];
        // 接收服务端回传的数据
        int len = socket.getInputStream().read(bytes);
        if (len != -1) {
            System.out.println("接收到服务端的数据:" + new String(bytes, 0, len));
        }
        socket.close();
    }
}
BIO 的缺点很明确:
- IO 代码里
read是阻塞操作,如果连接不做数据读写,处理它的线程会一直阻塞,白白浪费资源; - 一个连接一个线程,连接数一多线程就爆炸,线程的创建销毁、上下文切换都会给服务器带来巨大压力,这就是经典的 C10K 问题(单机同时处理 1 万个连接)。
应用场景:BIO 方式适用于连接数目比较小且固定的架构,这种方式对服务器资源要求比较高,但程序简单易理解。
伪异步 IO 模型图
连接数一多,线程无限创建显然不可控,最直接的优化就是引入线程池:处理方式仍然是「一个连接交给一个线程」,但线程从池子里取、用完还回去,不再无限膨胀。这个模型通常被称为「伪异步 IO,使用线程/线程池」。
它的结构是:
- 一个 Acceptor 线程只负责
accept()接收连接; - 收到连接后,把「与这个客户端交互」封装成任务,提交给线程池;
- 线程池里的工作线程从阻塞队列中取任务,执行阻塞式的读写逻辑。
完整代码如下:
package com.juzicoding.bio;

import java.io.IOException;
import java.net.ServerSocket;
import java.net.Socket;
import java.util.concurrent.ArrayBlockingQueue;
import java.util.concurrent.ThreadPoolExecutor;
import java.util.concurrent.TimeUnit;

/**
 * 伪异步 IO:Acceptor 线程只负责接收连接,读写逻辑交给线程池执行
 *
 * @author 橘子coding
 */
public class ThreadPoolServer {

    public static void main(String[] args) throws IOException {
        ServerSocket serverSocket = new ServerSocket(9000);
        // 核心线程 8 个,最大线程 16 个,任务队列容量 100
        ThreadPoolExecutor threadPool = new ThreadPoolExecutor(
                8, 16, 60L, TimeUnit.SECONDS,
                new ArrayBlockingQueue<>(100),
                new ThreadPoolExecutor.AbortPolicy());
        while (true) {
            System.out.println("等待连接。。");
            // accept 仍然阻塞,但只负责接收连接
            Socket clientSocket = serverSocket.accept();
            System.out.println("有客户端连接了。。");
            // 交给线程池处理,Acceptor 线程立刻回到 accept 等待下一个连接
            threadPool.execute(() -> {
                try {
                    handler(clientSocket);
                } catch (IOException e) {
                    e.printStackTrace();
                }
            });
        }
    }

    private static void handler(Socket clientSocket) throws IOException {
        byte[] bytes = new byte[1024];
        // 接收客户端的数据,阻塞方法:没有数据可读时就阻塞
        int read = clientSocket.getInputStream().read(bytes);
        if (read != -1) {
            System.out.println("接收到客户端的数据:" + new String(bytes, 0, read));
        }
        clientSocket.getOutputStream().write("HelloClient".getBytes());
        clientSocket.getOutputStream().flush();
    }
}
线程池版本比裸的 BIO 好了不少:线程可以复用,最大线程数可控,Acceptor 也不会被业务处理拖住。但「伪异步」的「伪」字就说明了一切——它看起来像异步(提交任务后立刻返回,继续接收下一个连接),本质仍然是同步阻塞 IO,只是把阻塞点从 Acceptor 线程挪到了工作线程:
- 工作线程和阻塞队列的容量都有限,连接一多,任务就开始排队;队列积满后新连接会被拒绝(或按拒绝策略处理);
- 一个连接一旦阻塞在
read上,就长期占着一个工作线程,慢连接会把线程池耗尽; - 它缓解了线程爆炸,但没有改变「一个线程处理一个连接」的本质,C10K 问题依然存在。
所以伪异步 IO 只是 BIO 的缓兵之计,真正的解法是让一个线程能同时盯住多个连接,也就是接下来的 NIO。
NIO
NIO 是什么
NIO(Non Blocking IO,非阻塞 IO)从 JDK 1.4 开始引入:同步非阻塞,服务器实现模式为一个线程可以处理多个请求(连接),客户端发送的连接请求都会注册到多路复用器 Selector 上,多路复用器轮询到连接有 IO 请求就进行处理。
应用场景:NIO 方式适用于连接数目多且连接比较短(轻操作)的架构,比如聊天服务器、弹幕系统、服务器间通讯,编程比较复杂。
先看不使用 Selector 的「非阻塞版」NIO,理解非阻塞的含义:
package com.juzicoding.nio;

import java.io.IOException;
import java.net.InetSocketAddress;
import java.nio.ByteBuffer;
import java.nio.channels.ServerSocketChannel;
import java.nio.channels.SocketChannel;
import java.util.ArrayList;
import java.util.Iterator;
import java.util.List;

/**
 * 非阻塞版 NIO 服务端:不使用 Selector,由应用层轮询所有连接
 *
 * @author 橘子coding
 */
public class NioServer {

    // 保存客户端连接
    static List<SocketChannel> channelList = new ArrayList<>();

    public static void main(String[] args) throws IOException, InterruptedException {

        // 创建 NIO ServerSocketChannel,与 BIO 的 ServerSocket 类似
        ServerSocketChannel serverSocket = ServerSocketChannel.open();
        serverSocket.socket().bind(new InetSocketAddress(9000));
        // 设置 ServerSocketChannel 为非阻塞
        serverSocket.configureBlocking(false);
        System.out.println("服务启动成功");

        while (true) {
            // 非阻塞模式 accept 方法不会阻塞,否则会阻塞
            // NIO 的非阻塞是由操作系统内部实现的,底层调用了 Linux 内核的 accept 函数
            SocketChannel socketChannel = serverSocket.accept();
            // 如果有客户端进行连接
            if (socketChannel != null) {
                System.out.println("连接成功");
                // 设置 SocketChannel 为非阻塞
                socketChannel.configureBlocking(false);
                // 保存客户端连接在 List 中
                channelList.add(socketChannel);
            }
            // 遍历连接进行数据读取
            Iterator<SocketChannel> iterator = channelList.iterator();
            while (iterator.hasNext()) {
                SocketChannel sc = iterator.next();
                ByteBuffer byteBuffer = ByteBuffer.allocate(128);
                // 非阻塞模式 read 方法不会阻塞,否则会阻塞
                int len = sc.read(byteBuffer);
                // 如果有数据,把数据打印出来
                if (len > 0) {
                    System.out.println("接收到消息:" + new String(byteBuffer.array(), 0, len));
                } else if (len == -1) {
                    // 如果客户端断开,把 socket 从集合中去掉
                    iterator.remove();
                    System.out.println("客户端断开连接");
                }
            }
        }
    }
}
这版代码把 accept 和 read 都设置成了非阻塞:没有连接时 accept 返回 null,没有数据时 read 返回 0,线程不会被卡住,可以继续往下执行。但缺点也很明显——它把「检查所有连接有没有数据」这件事交给了应用层轮询:
如果连接数太多的话,会有大量的无效遍历。假如有 10000 个连接,其中只有 1000 个连接有写数据,但是由于其他 9000 个连接并没有断开,我们还是要每次轮询遍历一万次,其中有十分之九的遍历都是无效的。
问题的本质是:应用层在挨个问每个 socket「你有没有数据」,而真正知道谁有数据的是操作系统内核。与其挨个问,不如把「哪些连接有事件」这件事也交给内核来做,这就是多路复用器 Selector:
package com.juzicoding.nio;

import java.io.IOException;
import java.net.InetSocketAddress;
import java.nio.ByteBuffer;
import java.nio.channels.SelectionKey;
import java.nio.channels.Selector;
import java.nio.channels.ServerSocketChannel;
import java.nio.channels.SocketChannel;
import java.util.Iterator;
import java.util.Set;

/**
 * 多路复用版 NIO 服务端:基于 Selector(Linux 底层为 epoll)
 *
 * @author 橘子coding
 */
public class NioSelectorServer {

    public static void main(String[] args) throws IOException, InterruptedException {

        // 创建 NIO ServerSocketChannel
        ServerSocketChannel serverSocket = ServerSocketChannel.open();
        serverSocket.socket().bind(new InetSocketAddress(9000));
        // 设置 ServerSocketChannel 为非阻塞
        serverSocket.configureBlocking(false);
        // 打开 Selector 处理 Channel,即创建 epoll
        Selector selector = Selector.open();
        // 把 ServerSocketChannel 注册到 selector 上,并且 selector 对客户端 accept 连接操作感兴趣
        serverSocket.register(selector, SelectionKey.OP_ACCEPT);
        System.out.println("服务启动成功");

        while (true) {
            // 阻塞等待需要处理的事件发生
            selector.select();

            // 获取 selector 中注册的全部事件的 SelectionKey 实例
            Set<SelectionKey> selectionKeys = selector.selectedKeys();
            Iterator<SelectionKey> iterator = selectionKeys.iterator();

            // 遍历 SelectionKey 对事件进行处理
            while (iterator.hasNext()) {
                SelectionKey key = iterator.next();
                // 如果是 OP_ACCEPT 事件,则进行连接获取和事件注册
                if (key.isAcceptable()) {
                    ServerSocketChannel server = (ServerSocketChannel) key.channel();
                    SocketChannel socketChannel = server.accept();
                    socketChannel.configureBlocking(false);
                    // 这里只注册了读事件,如果需要给客户端发送数据可以注册写事件
                    socketChannel.register(selector, SelectionKey.OP_READ);
                    System.out.println("客户端连接成功");
                } else if (key.isReadable()) {
                    // 如果是 OP_READ 事件,则进行读取和打印
                    SocketChannel socketChannel = (SocketChannel) key.channel();
                    ByteBuffer byteBuffer = ByteBuffer.allocate(128);
                    int len = socketChannel.read(byteBuffer);
                    // 如果有数据,把数据打印出来
                    if (len > 0) {
                        System.out.println("接收到消息:" + new String(byteBuffer.array(), 0, len));
                    } else if (len == -1) {
                        // 如果客户端断开连接,关闭 Socket
                        System.out.println("客户端断开连接");
                        socketChannel.close();
                    }
                }
                // 从事件集合里删除本次处理的 key,防止下次 select 重复处理
                iterator.remove();
            }
        }
    }
}
这里注意 new String(byteBuffer.array()) 的坑:ByteBuffer.allocate(128) 的 array() 返回的是整个底层数组,不限定长度就会把没写入数据的部分(一串空白字符)一起打印出来,所以必须写成 new String(byteBuffer.array(), 0, len)。
客户端为什么不能直接复用
到这里会自然想到:TCP 协议不区分服务端用的是 BIO 还是 NIO,那前面 BIO 的 SocketClient 是不是可以原样拿来连 NIO 服务端?答案是不能,问题出在「一来一回」上。
SocketClient 的流程是「发数据 → 等响应」:
socket.getOutputStream().write("HelloServer".getBytes());
socket.getOutputStream().flush();
System.out.println("向服务端发送数据结束");
byte[] bytes = new byte[1024];
// 接收服务端回传的数据
int len = socket.getInputStream().read(bytes);
而 NioSelectorServer 的 read 分支只打印、不回写,两者对不上:
Socket的getInputStream().read()是阻塞的,只要连接不断开、没有数据到来,它就一直等;NioSelectorServer的read分支处理完数据后没有write,服务端不会回任何东西。
结果就是客户端永远等不到响应,一直阻塞在 read 上。实际跑起来的现象是:服务端打印「接收到消息:HelloServer」,客户端打印完「向服务端发送数据结束」之后就再也没有下文,始终不会出现「接收到服务端的数据」。
改法一(推荐):不复用 BIO 客户端,改用 SocketClientNoReply
NIO 示例的服务端只读不回写,本来就不需要等响应,所以针对这个场景单独写一个「只发不收」的客户端:
package com.juzicoding.nio;

import java.io.IOException;
import java.net.Socket;

/**
 * 只发不收的客户端:NIO 示例的服务端只读不回写,发送完直接关闭连接
 *
 * @author 橘子coding
 */
public class SocketClientNoReply {

    public static void main(String[] args) throws IOException {
        Socket socket = new Socket("localhost", 9000);
        // 向服务端发送数据
        socket.getOutputStream().write("HelloServer".getBytes());
        socket.getOutputStream().flush();
        System.out.println("向服务端发送数据结束");
        // 服务端不回写响应,直接关闭连接,否则会一直阻塞在 read 上
        socket.close();
    }
}
它和 SocketClient 的唯一区别是:发完直接 close(),代码里根本没有「接收服务端回传的数据」那两行,自然不存在阻塞。
客户端 close() 不会把数据丢掉,因为数据早已写进内核的发送缓冲区,close() 只是随后发出 FIN(表示「我不会再发数据了」)。服务端下一次 read 会先读到缓冲区的数据返回正数,再读到 -1,所以服务端日志会依次出现「接收到消息:HelloServer」和「客户端断开连接」。
改法二:客户端不动,让 NIO 服务端支持回写
如果就是想让 SocketClient 原样复用,那要改的是服务端。在 NioSelectorServer 的 read 分支里,读到数据并打印之后补上回写:
// 如果有数据,把数据打印出来
if (len > 0) {
    System.out.println("接收到消息:" + new String(byteBuffer.array(), 0, len));
    // 回写响应前先 flip,把 Buffer 从读模式切回写模式
    byteBuffer.flip();
    socketChannel.write(byteBuffer);
} else if (len == -1) {
    ...
核心是 flip():刚才 read 已经把 position 移到了数据末尾,不先 flip() 把 limit 设为 position、position 归零,write 就会从末尾开始往外写,什么都写不出去。改完之后 BIO 的 SocketClient 不用动一个字就能收到回写并正常退出。
不过这只是演示级别的最小改法。真实场景里写缓冲区可能装满,一次 write 未必写得完,需要注册 OP_WRITE 事件,配合一个写队列在可写时继续写,也就是前面提到的「如果需要给客户端发送数据可以注册写事件」。
顺带一提,如果想亲眼看到「复用会卡死」这个现象,可以直接用
SocketClient去连NioSelectorServer,启动后客户端会一直停在那里不退出,而服务端日志已经打印出了收到的消息。
回到正题。看下来会发现,Selector 版代码的骨架已经很接近一个事件驱动模型:注册感兴趣的事件(register)→ 扫描是否有事件发生(select)→ 事件发生后做相应的处理(遍历 selectedKeys)。这个骨架就是 Reactor 模式的雏形。
底层原理:从 select/poll 到 epoll
NIO 在 JDK 1.4 版本是用 Linux 的内核函数 select() 或 poll() 来实现的,跟上面的 NioServer 类似:Selector 每次都会轮询所有的 SocketChannel,看哪个 Channel 有读写事件,有的话就处理,没有就继续遍历。JDK 1.5 开始引入了 epoll,基于事件响应机制来优化 NIO。
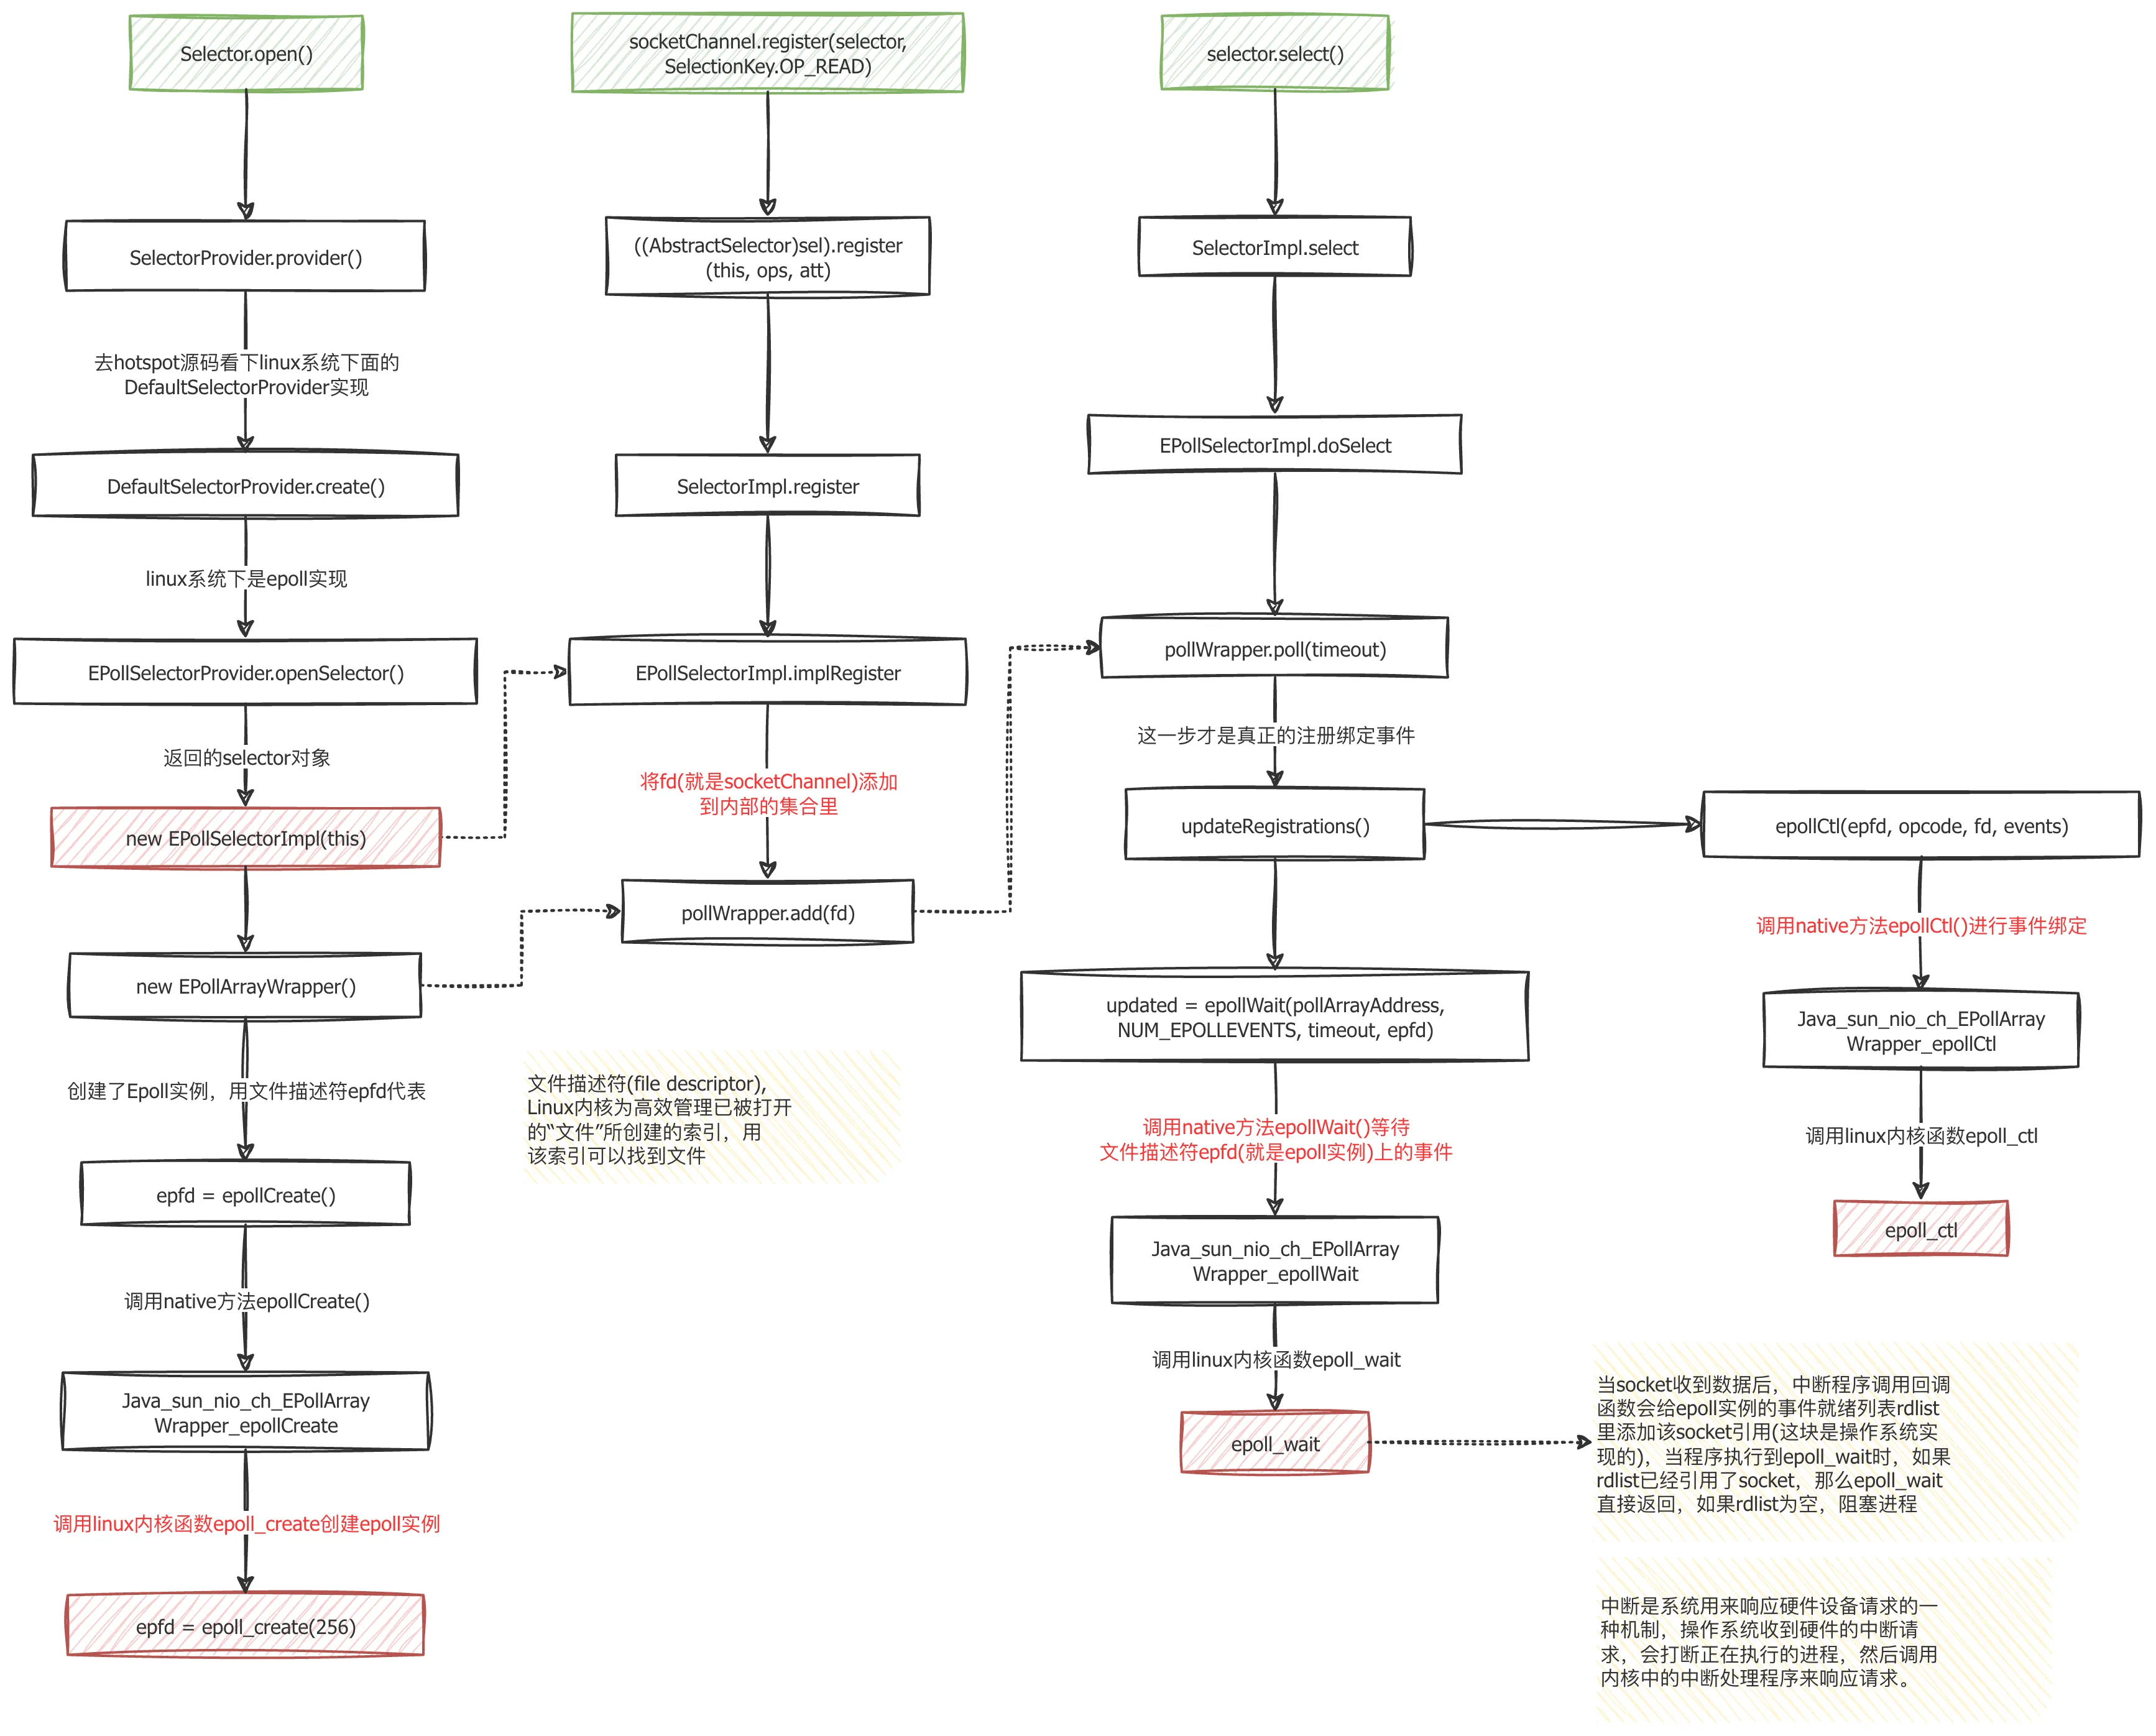
NioSelectorServer 代码里如下几个方法非常重要,我们从 HotSpot 与 Linux 内核函数级别来理解:
Selector.open()                                         // 创建多路复用器
socketChannel.register(selector, SelectionKey.OP_READ)  // 将 Channel 注册到多路复用器上
selector.select()                                       // 阻塞等待需要处理的事件发生
三者在 Linux 内核里的对应关系是:
| Java 层调用 | 内核函数 | 作用 |
|---|---|---|
Selector.open() | epoll_create() | 创建 epoll 实例,返回 epoll 文件描述符 |
channel.register(selector, ...) | epoll_ctl(EPOLL_CTL_ADD) | 把 socket fd 和关注的事件注册到 epoll 实例 |
selector.select() | epoll_wait() | 阻塞等待内核返回就绪事件 |
epoll 函数详解
int epoll_create(int size);创建一个 epoll 实例,并返回一个非负数作为文件描述符,用于对 epoll 接口的所有后续调用。参数 size 代表可能会容纳 size 个描述符,但它不是一个最大值,只是提示操作系统它的数量级,现在这个参数基本上已经弃用了。
int epoll_ctl(int epfd, int op, int fd, struct epoll_event *event);使用文件描述符 epfd 引用的 epoll 实例,对目标文件描述符 fd 执行 op 操作。参数 epfd 表示 epoll 对应的文件描述符,参数 fd 表示 socket 对应的文件描述符。
参数 op 有以下几个值:
EPOLL_CTL_ADD:注册新的 fd 到 epfd 中,并关联事件 event;EPOLL_CTL_MOD:修改已经注册的 fd 的监听事件;EPOLL_CTL_DEL:从 epfd 中移除 fd,并且忽略掉绑定的 event,这时 event 可以为 null。
参数 event 是一个结构体:
struct epoll_event {
    __uint32_t   events;      /* Epoll events */
    epoll_data_t data;        /* User data variable */
};

typedef union epoll_data {
    void        *ptr;
    int          fd;
    __uint32_t   u32;
    __uint64_t   u64;
} epoll_data_t;
events 有很多可选值,这里只举最常见的几个:
EPOLLIN:表示对应的文件描述符是可读的;EPOLLOUT:表示对应的文件描述符是可写的;EPOLLERR:表示对应的文件描述符发生了错误。
成功则返回 0,失败返回 -1。
int epoll_wait(int epfd, struct epoll_event *events, int maxevents, int timeout);等待文件描述符 epfd 上的事件。epfd 是 epoll 对应的文件描述符,events 表示调用者所有可用事件的集合,maxevents 表示最多等到多少个事件就返回,timeout 是超时时间。
小结一下 NIO 的整个调用流程:Java 调用了操作系统的内核函数来创建 Socket,获取到 Socket 的文件描述符;再创建一个 Selector 对象,对应操作系统的 epoll 描述符;将获取到的 Socket 连接的文件描述符的事件绑定到 Selector 对应的 epoll 文件描述符上,进行事件的异步通知。这样就实现了使用一条线程,并且不需要太多的无效遍历,将事件处理交给了操作系统内核(操作系统中断程序实现),大大提高了效率。
补充一句:I/O 多路复用底层主要用的就是 Linux 内核函数(select、poll、epoll),Windows 不支持 epoll,Windows 底层基于 Winsock 2 的 select 函数实现(不开源)。
这是为您整理的 Markdown 格式表格:
| 对比项 | select | poll | epoll(Linux 下 JDK 1.5+) |
|---|---|---|---|
| 操作方式 | 遍历 | 遍历 | 事件通知(回调) |
| 底层实现 | 位图(fd_set) | 数组(pollfd) | 红黑树 + 就绪链表 |
| IO效率 | 每次调用都进行线性遍历,时间复杂度为 O(n) | 每次调用都进行线性遍历,时间复杂度为 O(n) | 通过 epoll_wait() 获取就绪事件,避免遍历全部监听的 fd,时间复杂度 O(1)(O(k)) |
| 最大连接 | 有上限(通常 1024) | 无固定上限(受系统限制) | 无固定上限(受系统限制) |
Redis 线程模型
Redis 就是典型的基于 epoll 的 NIO 线程模型(Nginx 也是),epoll 实例收集所有事件(连接与读写事件),由一个服务端线程连续处理所有事件命令。Redis 底层关于 epoll 的源码实现在 Redis 源码目录的 ae_epoll.c 文件里。
核心组件
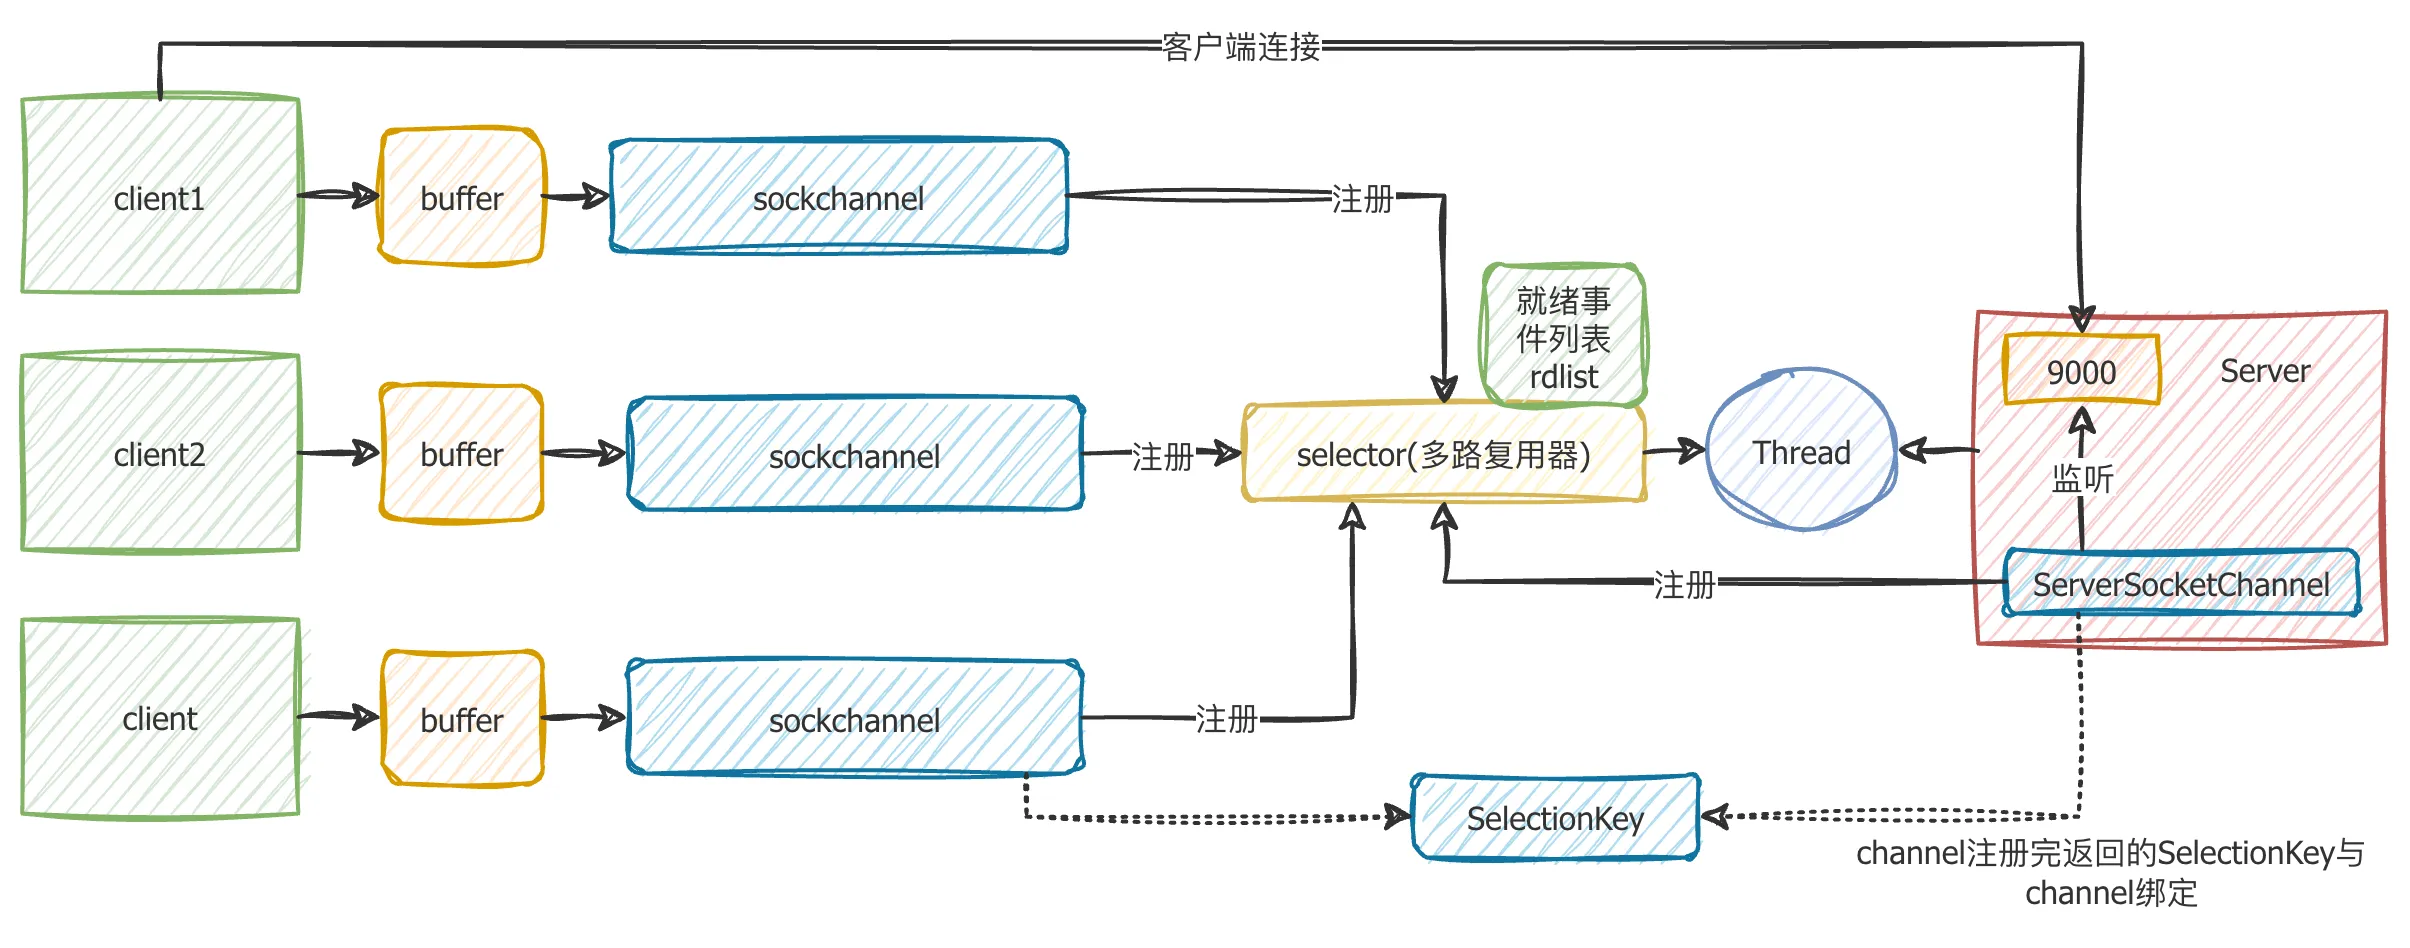
NIO 有三大核心组件:Channel(通道)、Buffer(缓冲区)、Selector(多路复用器)。
- Channel 类似于流,每个 Channel 对应一个 Buffer 缓冲区,Buffer 底层就是个数组;
- Channel 会注册到 Selector 上,由 Selector 根据 Channel 读写事件的发生,将其交由某个空闲的线程处理;
- NIO 的 Buffer 和 Channel 都是既可以读也可以写的。
Channel(通道)
Channel 与传统流最大的区别是双向:一个流要么读、要么写,而 Channel 同时支持读写,并且必须配合 Buffer 使用——读数据是把数据从 Channel 读到 Buffer,写数据是把 Buffer 里的数据写入 Channel。常用实现有:
| 实现 | 用途 |
|---|---|
ServerSocketChannel | 服务端监听 TCP 连接 |
SocketChannel | 客户端或已连接的服务端进行 TCP 读写 |
DatagramChannel | UDP 读写 |
FileChannel | 文件读写 |
Buffer(缓冲区)
Buffer 本质是一块可读写内存(底层多为数组或堆外内存)。以最常用的 ByteBuffer 为例,它有三个关键属性:
capacity:容量,创建后不可变;position:下一个要读或写的位置;limit:读写的边界。
写入数据时 position 向后移动;读数据前要先 flip(),把 limit 设为当前 position、position 归零,切换成读模式;读完用 clear()(或 compact())复位,切回写模式。「为什么读完要 flip」这个常见疑问,就是 position 和 limit 在读写模式下语义不同导致的。
Selector(多路复用器)
Selector 负责同时监听多个 Channel 上的事件。每个 Channel 注册到 Selector 时会返回一个 SelectionKey,里面保存了「谁在关心什么事件、以及附带的数据」。四种事件:
OP_ACCEPT:有新的连接可以接入(ServerSocketChannel);OP_CONNECT:连接建立完成(SocketChannel客户端);OP_READ:有数据可读;OP_WRITE:可以写入数据(写缓冲区有空闲)。
注意,Channel 必须配置为非阻塞模式,才能注册到 Selector 上。
三者协作的最小闭环,就是前面 NioSelectorServer 的流程:
- 创建 Selector;
- 把 Channel 注册到 Selector,并声明感兴趣的事件;
- 调用
select()阻塞等待,直到有事件就绪; - 遍历
selectedKeys(),按事件类型分发处理; - 处理完的 key 从集合中移除,避免下次重复处理。
Reactor 模式
Reactor 模式是网络编程里最经典的事件驱动设计模式,Netty、Redis、Nginx、Tomcat 里都能看到它。它的核心思想可以用三步概括:
注册感兴趣的事件 → 扫描是否有感兴趣的事件发生 → 事件发生后做出相应的处理。
对照 NioSelectorServer 的代码,这三步的对应关系非常直接:
| Reactor 三步 | NIO 里的实现 |
|---|---|
| 注册感兴趣的事件 | channel.register(selector, SelectionKey.OP_READ) |
| 扫描是否有事件发生 | selector.select(),阻塞等待,由内核通知就绪事件 |
| 事件发生后处理 | 遍历 selectedKeys(),按事件类型分发到对应的处理逻辑 |
其中 Selector 负责「扫描」,register 负责「注册」,「分发」由应用代码完成。把这套流程抽象出来就是 Reactor 模式;把角色再拆一拆,又演化出不同的线程模型:
- 单 Reactor 单线程:一个线程包办 accept、读写、业务处理。实现最简单,Redis 就是这种模型(Redis 6 之后网络 IO 引入了多线程,但核心命令处理仍是单线程);缺点是耗时的业务处理会卡住整个事件循环。
- 单 Reactor 多线程:Reactor 线程只负责接收连接和读写事件分发,真正的业务处理丢给线程池,避免耗时逻辑卡住事件循环。
- 主从 Reactor 多线程:主 Reactor 只负责 accept,把连接交给从 Reactor;从 Reactor 负责读写事件分发,业务处理再交给工作线程池。Netty 采用的就是这种模型:bossGroup 对应主 Reactor,workerGroup 对应从 Reactor。
一句话总结 Reactor 的价值:它把「等待事件」和「处理事件」解耦,等待交给少量线程(甚至一个),处理可以按需扩展,从而用有限的线程支撑海量连接——这正是 Netty 高性能的根基。
三种 IO 模型对比
| 对比项 | BIO | NIO | AIO |
|---|---|---|---|
| IO 模型 | 同步阻塞 | 同步非阻塞(I/O 多路复用) | 异步非阻塞 |
| 编程难度 | 简单 | 复杂 | 复杂,依赖操作系统支持 |
| 可靠性 | 差 | 好 | 好 |
| 吞吐量 | 低 | 高 | 高 |
| 适用场景 | 连接数小且固定 | 连接数多且连接短(轻操作) | 连接数多且连接长(重操作) |
| JDK 支持 | JDK 1.0 | JDK 1.4 | JDK 7 |
AIO(NIO 2.0)是异步非阻塞:由操作系统完成后回调通知服务端程序,启动线程去处理,一般适用于连接数较多且连接时间较长的应用,JDK 7 开始支持。
既然 AIO 看起来更先进,Netty 为什么不用 AIO?
在 Linux 系统上,AIO 的底层实现仍使用 epoll,没有很好实现 AIO,因此在性能上没有明显的优势,而且被 JDK 封装了一层不容易深度优化,Linux 上 AIO 还不够成熟。Netty 是异步非阻塞框架,Netty 在 NIO 上做了很多异步的封装。