
Redis高可用
1. Redis 性能测试
Redis 的所有数据都保存在内存里,内存的读写速度非常快,所以 Redis 的性能特别强悍。但内存也有个缺点:一断电,数据就全丢了。所以实际项目里,只要需要用 Redis 保存重要数据,就不能只靠内存。
因此,在真实项目里用 Redis,一定要结合实际应用场景估算一下性能,在数据安全性和读写性能之间找到一个平衡点。
Redis 自带了一个压测工具 redis-benchmark,可以快速给 Redis 做一次基准测试:
# 20 个并发客户端,100 万个请求,测试 set 指令(写操作)
redis-benchmark -a <password> -t set -n 1000000 -c 20

Summary:
  throughput summary: 123411.09 requests per second
  latency summary (msec):
          avg       min       p50       p95       p99       max
        0.089     0.024     0.087     0.103     0.143     1.079
几个常用参数:
| 参数 | 说明 |
|---|---|
-t | 指定要压测的指令,例如 set、get、lpush,多个指令用逗号分隔 |
-n | 请求总数 |
-c | 并发客户端连接数 |
-a | 连接 Redis 的密码 |
更多参数可以用 redis-benchmark --help 查看。上面这次压测每秒大约能处理 12.3 万次写操作,输出结果分两部分:
throughput summary:吞吐量,也就是每秒成功处理的请求数,用来衡量 Redis 的极限处理能力。latency summary:延迟统计,单位是毫秒。除了平均值avg,还有min、p50、p95、p99、max等分位值。分位值比平均值更能反映真实体验,比如这次p99 = 0.143,意思是 99% 的请求都在 0.143 毫秒内返回;平均值虽然很低,但max很高,说明偶尔会有慢请求。
提示
压测结果跟机器配置、是否开启持久化、部署架构都有关系,这里的数字只是本次压测环境下的结果,不要直接当成线上容量指标,建议多测几次对比一下。
2. 持久化机制
官网介绍地址:https://redis.io/docs/latest/operate/oss_and_stack/management/persistence/
Redis 提供了很多与数据持久化相关的配置,组合起来可以形成以下几种策略:
| 策略 | 说明 |
|---|---|
| 无持久化 | 完全关闭数据持久化,不保证数据安全,相当于把 Redis 当作纯缓存使用 |
| RDB(Redis Database) | 按一定的时间间隔保存 Redis 所有数据的快照 |
| AOF(Append Only File) | 记录 Redis 收到的每一次写操作,可以通过操作重演的方式恢复 Redis 的数据 |
| RDB + AOF | 同时保存 Redis 的数据和操作 |
RDB 和 AOF 是最常用的两种方式,它们的优缺点对比如下。
RDB
优点:
- RDB 文件非常紧凑,很适合定期备份数据。
- RDB 快照非常适合灾难恢复。
- RDB 备份速度非常快,对主线程的性能几乎没有影响:备份时主线程只需要 fork 一个负责备份的子进程,所有备份工作都由子进程完成,基本不影响主线程的 IO 性能。
- 与 AOF 相比,数据量大时 RDB 的恢复速度快很多。
缺点:
- RDB 无法实时备份数据,因此总有丢失数据的可能。
- RDB 需要 fork 子进程来完成备份。fork 采用写时复制机制,并不会立刻复制全部数据,但会带来额外的内存开销,fork 本身也会短暂阻塞主线程。如果数据量太大,或者 CPU 性能不佳,RDB 方式就容易造成 Redis 短暂停顿。相比之下,AOF 虽然重写时也需要 fork,但重写频率较低,并且可以通过配置调整。
AOF
优点:
- AOF 持久化更安全。例如 Redis 默认每秒执行一次 AOF 同步(fsync),这样即使服务崩溃,最多也只丢失一秒内的写操作。
- AOF 以追加的方式记录操作,正常情况下不会出现记录不完整的情况。即使因为特殊原因造成某条操作记录不完整,也可以使用
redis-check-aof工具轻松恢复。 - 当 AOF 文件过大时,Redis 会自动切换到新的日志文件,避免单个文件体积过大的问题。
- AOF 记录操作的方式简单易懂,可以很轻松地自行修改日志。比如误执行了一次
FLUSHALL把数据删掉了,只要把日志中最后一条FLUSHALL指令删掉再重启数据库,就可以恢复所有数据。
缺点:
- 相同数据集下,AOF 文件通常比 RDB 文件更大。
- 写操作频繁时,AOF 的备份性能通常比 RDB 更差。
整体使用建议:
- 如果只是把 Redis 当作缓存使用,可以直接关闭持久化。
- 如果更关注数据安全性,并且可以接受服务异常宕机时的小部分数据丢失,那么可以只使用 RDB 策略,性能比较高。
- 不建议单独使用 AOF,RDB 配合 AOF 可以让数据恢复的过程更快。
2.1 RDB 详解
1、RDB 的作用
RDB 可以在指定的时间间隔,把当前时间点内存中的全部数据集备份到磁盘文件,通常是 dump.rdb 文件。恢复时,再把磁盘中的快照文件直接读回内存。
由于 RDB 存的是全量数据,甚至可以直接用它来传递数据。例如想把一个 Redis 服务的数据同步到另一个 Redis 服务(最好是同版本),直接复制最近的 RDB 文件即可。
2、相关重要配置
| 配置 | 说明 |
|---|---|
save <seconds> <changes> | 核心配置。在指定的秒数内,如果发生了指定次数的写操作,就保存一次数据快照 |
save "" | 关闭 RDB 快照 |
dir | 数据存储目录 |
dbfilename | RDB 文件名,默认 dump.rdb |
rdbcompression | 是否启用 RDB 压缩,默认 yes。如果不想消耗 CPU 进行压缩,可以设置为 no |
stop-writes-on-bgsave-error | 默认 yes。配置成 no 时,表示你不在乎数据不一致,或者有其他手段发现和控制这种不一致,这样即使快照写入失败,Redis 也能继续接受新的写入请求 |
rdbchecksum | 默认 yes。存储快照后,可以让 Redis 使用 CRC64 算法进行数据校验,但会增加大约 10% 的性能消耗。如果希望获得最大的性能提升,可以关闭此功能 |
redis.conf 中 save 的默认策略如下:
# Save the DB to disk.
#
# save <seconds> <changes> [<seconds> <changes> ...]
#
# Redis will save the DB if the given number of seconds elapsed and it
# surpassed the given number of write operations against the DB.
#
# Snapshotting can be completely disabled with a single empty string argument
# as in following example:
#
# save ""
#
# Unless specified otherwise, by default Redis will save the DB:
#   * After 3600 seconds (an hour) if at least 1 change was performed
#   * After 300 seconds (5 minutes) if at least 100 changes were performed
#   * After 60 seconds if at least 10000 changes were performed
#
# You can set these explicitly by uncommenting the following line.
#
# save 3600 1 300 100 60 10000
3、何时会触发 RDB 备份
- 满足配置文件中的快照条件时,会自动触发 RDB 快照。
- 手动执行
save或者bgsave指令时,会触发 RDB 快照。其中save命令会在备份期间阻塞主线程;bgsave不会长时间阻塞主线程,但会 fork 一个子进程进行持久化,fork 采用写时复制机制,会带来额外的内存和 CPU 开销。 - 主从复制时会触发 RDB 备份。
4、查看最后一次快照时间
LASTSAVE 指令可以查看最后一次成功执行快照的时间。返回值是一个 Unix 时间戳(秒),在 Linux 中可以用 date -d @{timestamp}(例如:date -d @1789308730)快速格式化。
2.2 AOF 详解
1、AOF 的作用
AOF 以日志的形式记录每个写操作(读操作不记录),只允许追加内容,不允许改写文件。
2、相关重要配置
| 配置 | 说明 |
|---|---|
appendonly | 是否开启 AOF,默认不开启 |
appendfilename | 文件名称,默认 appendonly.aof |
appendfsync | 同步方式。默认 everysec,每秒同步一次;no 不主动 fsync,由操作系统决定何时刷盘;always 每次写操作都同步,数据更安全,但性能较低 |
appenddirname | AOF 文件目录,Redis 7 新增参数,指定 AOF 日志的文件目录。实际目录是 {dir}/{appenddirname} |
auto-aof-rewrite-percentage、auto-aof-rewrite-min-size | 文件重写触发策略。默认 AOF 文件至少达到 64MB,且比上次重写后增长 100%(即翻倍)时,触发一次重写 |
no-appendfsync-on-rewrite | AOF 重写期间是否同步 |
3、AOF 文件组织与重写
Redis 7 对 AOF 的文件组织做了调整,原本只有一个文件,现在拆成了三个文件:
# Append-only file names are created by Redis following a specific pattern.
# The file name's prefix is based on the 'appendfilename' configuration
# parameter, followed by additional information about the sequence and type.
# For example, if appendfilename is set to appendonly.aof, the following file
# names could be derived:
# - appendonly.aof.1.base.rdb as a base file.
# - appendonly.aof.1.incr.aof, appendonly.aof.2.incr.aof as incremental files.
# - appendonly.aof.manifest as a manifest file.
appendfilename "appendonly.aof"appendonly.aof.1.base.rdb:base 文件,即二进制的数据文件,是文件创建时数据集的完整快照。appendonly.aof.1.incr.aof:增量文件,记录在上一个文件之后应用到数据集上的新操作。appendonly.aof.manifest:manifest 文件,记录文件信息以及它们创建和应用的顺序。
在 Redis 7 之前的版本中,AOF 文件也会包含二进制的 RDB 部分和文本的 AOF 部分。Redis 7 把这两部分拆成了单独的文件,既便于数据恢复,也便于控制 AOF 文件的大小。从这几个文件可以看出,现在的 AOF 已经具备了 RDB + AOF 的功能,而拆分增量文件的方式,也能进一步控制 AOF 文件的大小。
Redis 会定期对 AOF 中的操作进行重写优化,让记录更为精简,例如将多个 INCR 指令合并成一个 SET 指令。同时,Redis 7 的 AOF 重写会生成新的 base rdb 文件和 incr.aof 文件。AOF 重写也可以通过 BGREWRITEAOF 指令手动触发。
4、AOF 文件内容解析
示例:打开 AOF 配置(AOF 日志文件为 appendonly.aof),使用 redis-cli 连接 Redis 服务,简单执行两个 set 操作:
[root@192-168-65-214 myredis]# redis-cli -a 123qweasd
127.0.0.1:6379> keys *
(empty array)
127.0.0.1:6379> set k1 v1
OK
127.0.0.1:6379> set k2 v2
OK
打开 appendonly.aof.1.incr.aof 增量文件可以看到,里面其实是以 Redis 协议记录了每一次操作。
$3
set
$2
k1
$2
v1
*3
$3
set
$2
k2
$2
v2
Redis 通过 TCP 协议一次次解析各个指令,遵循的就是这套指令协议。了解这个协议后,甚至可以很轻松地自己写一个 Redis 客户端。
RESP 协议
引用 Redis 官网 中有一段对 RESP 协议的描述。
Redis clients communicate with the Redis server using a protocol called RESP (REdis Serialization Protocol). While the protocol was designed specifically for Redis, it can be used for other client-server software projects.
RESP is a compromise between the following things:
- Simple to implement.
- Fast to parse.
- Human readable.
翻译过来就是:Redis 客户端使用一种称为 RESP(Redis 序列化协议)的协议与 Redis 服务器通信。虽然该协议是专门为 Redis 设计的,但它可以用于其他客户机-服务器软件项目。 具有以下特点:实现简单,解析速度快,人类可读。
RESP 的底层实现原理
RESP 底层采用的是 TCP 的连接方式,通过 TCP 进行数据传输,然后根据 解析规则 解析相应信息,完成交互。
我们可以写个简单的例子来测试下,首先运行一个 ServerSocket 监听 6379,来接收 Redis 客户端的请求信息,实现如下。
服务端代码:
// 写一个伪的 redis
public class ServerRedis {
    public static void main(String[] args) {
        try {
            ServerSocket serverSocket = new ServerSocket(6379);
            Socket socket = serverSocket.accept();
            byte[] result = new byte[2048];
            socket.getInputStream().read(result);
            System.out.println(new String(result));
        } catch (IOException e) {
            e.printStackTrace();
        }
    }
}
客户端代码:
public class ClientTest {
    public static void main(String[] args) {
        Jedis jedis = new Jedis("127.0.0.1",6379);
        jedis.set("name","zhangsan");
        jedis.close();
    }
}
启动服务器端,启动客户端发送消息,客户端报错(因为 Jedis 还需要返回,而我们写的伪 Redis 端没有按格式返回),服务器端打印如下结果:
*3
$3
SET
$4
name
$9
zhangsan
这就是 RESP 协议的规则。
*3  // *标识后面有几组数据,set key value,三组所以*3
$3  // $标识 SET 的长度,所以$3
SET
$4  // $标识 name 的长度,所以$4
name
$9  // $标识 value 的长度,所以$9
zhangsan
5、AOF 日志恢复
如果 Redis 服务出现意外情况,可能造成 AOF 日志中的指令记录不完整。例如手动编辑 appendonly.aof.1.incr.aof 日志文件,在末尾随便输入一段文字,就可以模拟指令记录不完整的情况,这时重启 Redis 服务会发现启动失败,这时必须先修复日志文件,然后才能启动:
[root@vm12 appendonlydir]# redis-check-aof --fix appendonly.aof.1.incr.aof
Start checking Old-Style AOF
AOF appendonly.aof.1.incr.aof format error
AOF analyzed: filename=appendonly.aof.1.incr.aof, size=89, ok_up_to=81, ok_up_to_line=20, diff=8
This will shrink the AOF appendonly.aof.1.incr.aof from 89 bytes, with 8 bytes, to 81 bytes
Continue? [y/N]: y
Successfully truncated AOF appendonly.aof.1.incr.aof
修复的过程实际上就是把最后那条不完整的指令删除掉。注意,Redis 同样提供了 RDB 文件的修复指令 redis-check-rdb,但 RDB 是二进制压缩文件,一般不太可能被篡改,所以用得并不多。
2.3 混合持久化策略
RDB 和 AOF 两种持久化策略各有优劣,因此 Redis 也支持同时开启两者。在 redis.conf 配置文件中,有一个参数可以同时打开 RDB 和 AOF 两种持久化策略:
# Redis can create append-only base files in either RDB or AOF formats. Using
# the RDB format is always faster and more efficient, and disabling it is only
# supported for backward compatibility purposes.
aof-use-rdb-preamble yes
这也说明,同时开启 RDB 和 AOF 两种持久化策略时,Redis 恢复数据会优先从 AOF 的持久化文件开始恢复:一方面 AOF 的数据集通常比 RDB 更完整,另一方面 AOF 中已经包含了 RDB 格式的 base 文件,恢复效率也比较高。
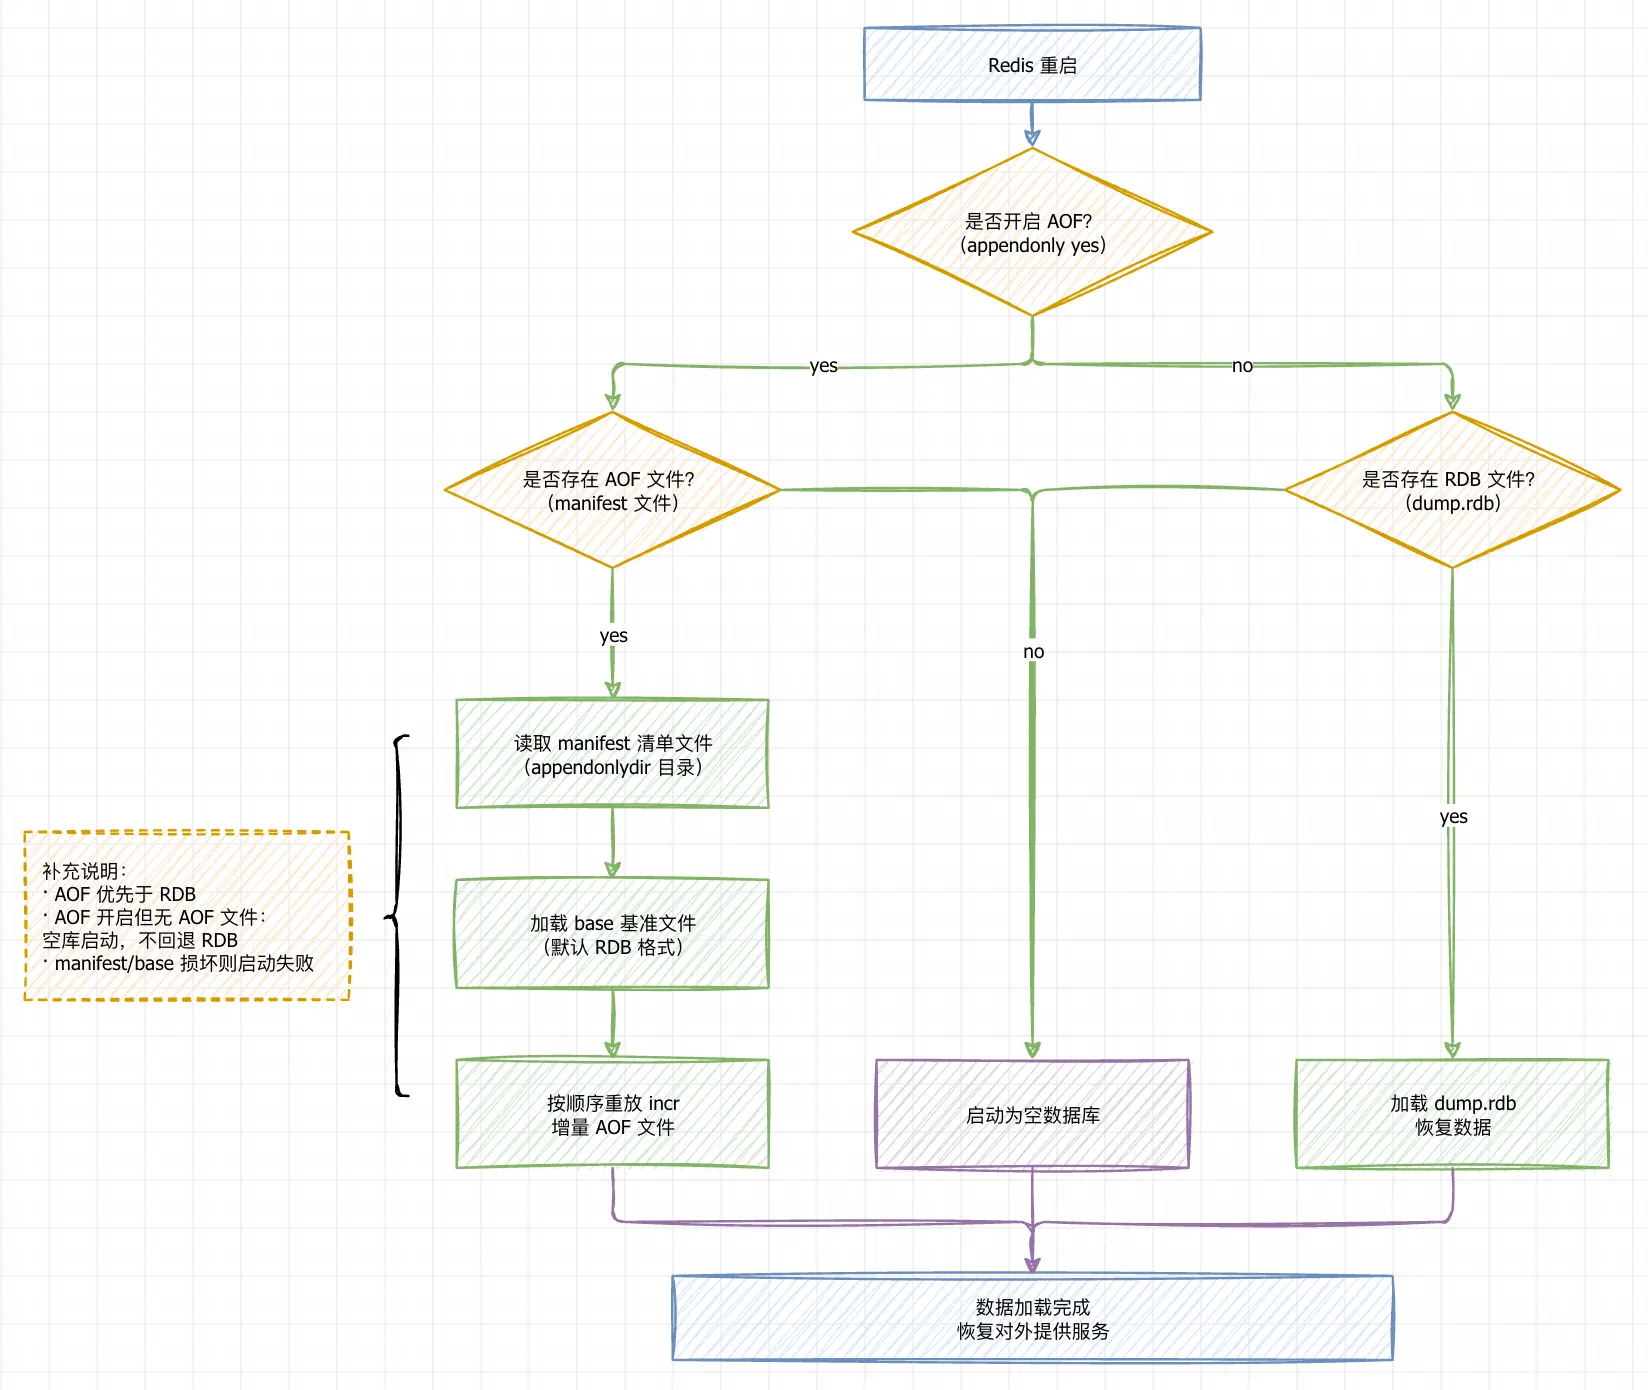
但要注意,既然服务重启时只找 AOF 文件,那是不是就不需要做 RDB 备份了呢?通常还是建议保留 RDB 文件并定期备份:AOF 数据在不断变化,不利于定期归档,而 RDB 文件紧凑、适合备份,可以作为数据安全的最后一道保障。
最后需要注意,Redis 的持久化策略只能保证单机的数据安全。如果服务器的磁盘损坏,再好的持久化策略也保证不了数据安全。如果希望进一步提升数据安全性,就需要引入下面几种集群化方案。
3. 主从复制(Replication)
上一节说到,持久化只能保证单机的数据安全,服务器磁盘一旦损坏,再好的持久化策略也救不回来数据。接下来的三种集群化方案——主从复制、哨兵集群、Redis 集群——都是在分布式场景下保护 Redis 数据安全以及分摊流量的方案,它们层层递进,主从复制是后面哨兵与集群的基础。
类似于 MySQL 的读写分离,一台 Redis(主节点)进行写,其他 Redis(从节点)进行读。
从节点建议用只读模式 replica-read-only yes,若从节点能修改数据,主从数据就会不一致,主节点数据更改后从节点数据又被覆盖,没有任何意义。
传输延迟:主从一般部署在不同机器上,复制时存在网络延时问题,Redis 提供了 repl-disable-tcp-nodelay 参数决定是否关闭 TCP_NODELAY,默认值为 no,即默认不关闭 TCP_NODELAY。
- 参数关闭时(
repl-disable-tcp-nodelay no):无论数据包大小都会及时发布到从节点,占用带宽,适用于主从网络好的场景。 - 参数启用时(
repl-disable-tcp-nodelay yes):主节点合并所有数据成 TCP 包节省带宽,默认 40 毫秒发一次(取决于内核),主从的同步延迟 40 毫秒,适用于网络环境复杂或带宽紧张的场景,如跨机房。
3.1 主从复制搭建
如果你还不知道怎么单机搭建,参考 Linux 安装 Redis。主从复制需要多台机器,三台机器都需要先按该文档安装并启动好 Redis。
本例使用三台机器搭建一主两从,角色分配如下:
| 主机名 | 机器 | 角色 | 端口 |
|---|---|---|---|
| vm21 | 192.168.1.21 | 主节点 | 6379 |
| vm22 | 192.168.1.22 | 从节点 | 6379 |
| vm23 | 192.168.1.23 | 从节点 | 6379 |
1、主节点操作
192.168.1.21 作为主节点,角色配置不需要更改,先确认 Redis 已启动,再放行 6379 端口:
# 确认 redis 已启动
[root@vm21 ~]# ps -ef | grep redis
root      7059       1  0 19:29 ?        00:00:02 /data/soft/redis/bin/redis-server 0.0.0.0:6379

# 跨机器搭建时,主节点需要确认两件事,否则从节点连不上:
# 1、配置文件中的 bind 为 0.0.0.0,允许其他机器访问
# 2、防火墙放行 6379 端口
[root@vm21 ~]# firewall-cmd --add-port=6379/tcp --permanent
[root@vm21 ~]# firewall-cmd --reload
2、从节点操作
192.168.1.22 和 192.168.1.23 两台从节点操作相同,分别往各自的配置文件中追加主节点 IP 及端口、密码,然后重启 Redis,以 vm22 为例:
# 两台机器分别追加以下内容
[root@vm22 ~]# cat >> /data/soft/redis/etc/redis.conf << 'EOF'

# 主节点 IP 及端口、密码
slaveof 192.168.1.21 6379
masterauth 123456
EOF

# 重启 redis
[root@vm22 ~]# systemctl restart redis.service
3、查看效果
在主节点上查看主从状态,connected_slaves 为 2 说明两台从节点都已连接成功:
[root@vm21 ~]# redis-cli -p 6379 -a 123456
127.0.0.1:6379> info replication
# Replication
role:master
connected_slaves:2
slave0:ip=192.168.1.22,port=6379,state=online,offset=42,lag=1
slave1:ip=192.168.1.23,port=6379,state=online,offset=42,lag=1
master_failover_state:no-failover
master_replid:d219c0cf4dad209643748197f64e868df2116e34
master_replid2:0000000000000000000000000000000000000000
master_repl_offset:42
second_repl_offset:-1
repl_backlog_active:1
repl_backlog_size:1048576
repl_backlog_first_byte_offset:1
repl_backlog_histlen:42
127.0.0.1:6379> exit
登录主节点写入数据:
[root@vm21 ~]# redis-cli -p 6379 -a 123456
127.0.0.1:6379> set userName zhangsan
OK
127.0.0.1:6379> exit
分别登录从节点 192.168.1.22 和 192.168.1.23 查看数据:
[root@vm22 ~]# redis-cli -p 6379 -a 123456
127.0.0.1:6379> get userName
"zhangsan"
127.0.0.1:6379> exit
提示
从节点连接主节点时,如果主节点配置了 requirepass 而从节点没有配置 masterauth,从节点会一直报 NOAUTH 错误,info replication 中 master_link_status 显示为 down。跨机器搭建时排查顺序:先确认网络互通与主节点防火墙,再检查密码配置。
命令补充
# 查看状态:
info replication

# 断开主从复制:在从节点,执行
127.0.0.1:6379> slaveof no one

# 断开后再变成主从复制
127.0.0.1:6379> slaveof 192.168.1.21 6379
3.2 主从复制拓扑结构
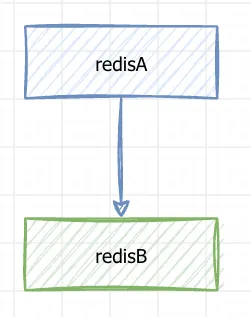
1、一主一从
用于主节点故障转移从节点,当主节点的「写」命令并发高且需要持久化时,可以只在从节点开启 AOF(主节点不需要),这样既保证了数据的安全性,也避免了持久化对主节点的影响。
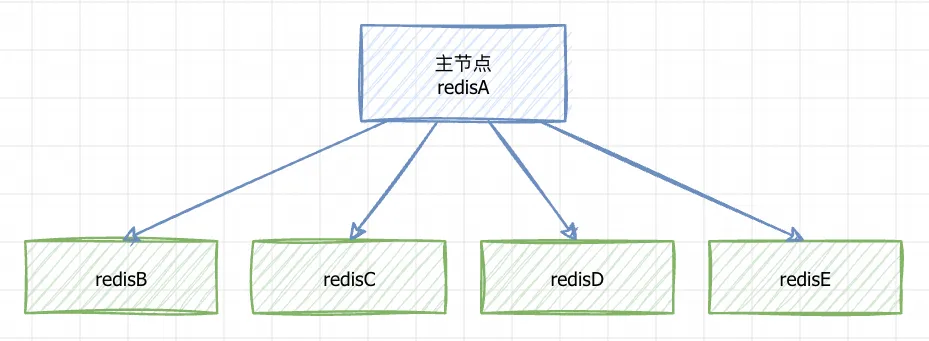
2、一主多从
针对「读」较多的场景,「读」由多个从节点来分担,但节点越多,主节点同步到多节点的次数也越多,影响带宽,也加重主节点的稳定性负担。
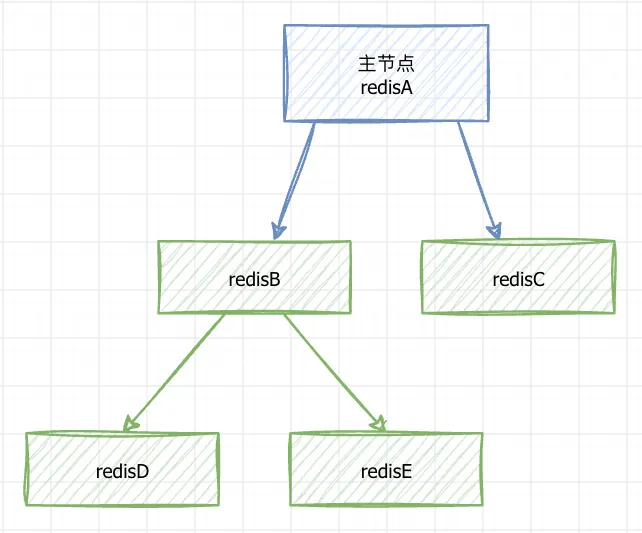
3、树状主从
一主多从的缺点(主节点推送次数多、压力大)可以用下面的方案解决:主节点只推送一次数据到从节点 1,再由从节点 1 推送给它下面的从节点,逐层往下传递,从而减轻主节点的推送压力。
3.3 复制原理
在从节点配置 slaveof 192.168.1.21 6379 并启动后,从节点会与主节点建立连接并同步数据。192.168.1.22 和 192.168.1.23 两台从节点都会执行这一过程,整个过程大致分为 6 步:
- 保存主节点信息:从节点保存配置中的主节点 IP 和端口。
- 主从建立 socket 连接:从节点与主节点建立网络连接。
- 发送 ping 命令:从节点向主节点发送 ping,确认主节点可以正常响应。
- 权限验证:主节点配置了密码时,从节点需要带上
masterauth密码通过验证。 - 同步数据集:首次连接执行全量同步,将主节点的数据集同步到从节点。
- 命令持续复制:同步完成后,主节点持续把新的写命令复制给从节点,保持主从数据一致。
在从节点执行 info replication 可以查看主从及同步信息,其中 master_host 为主节点 IP,master_link_status:up 表示连接正常:
[root@vm22 ~]# redis-cli -p 6379 -a 123456
127.0.0.1:6379> info replication
# Replication
role:slave
master_host:192.168.1.21
master_port:6379
master_link_status:up
master_last_io_seconds_ago:1
master_sync_in_progress:0
slave_read_repl_offset:904
slave_repl_offset:904
slave_priority:100
slave_read_only:1
replica_announced:1
connected_slaves:0
master_failover_state:no-failover
master_replid:d219c0cf4dad209643748197f64e868df2116e34
master_replid2:0000000000000000000000000000000000000000
master_repl_offset:904
second_repl_offset:-1
repl_backlog_active:1
repl_backlog_size:1048576
repl_backlog_first_byte_offset:275
repl_backlog_histlen:630
数据同步
Redis 2.8 版本以上使用 psync 命令完成同步,过程分「全量」与「部分」复制。
- 全量复制:一般用于初次复制场景(第一次建立 SLAVE 后全量)。
- 部分复制:网络出现问题,从节点再次连主节点时,主节点补发缺少的数据,每次数据增加同步。
- 心跳:主从有长连接心跳,主节点默认每 10 秒向从节点发 ping 命令,由参数
repl-ping-replica-period控制发送频率。
3.4 复制工作流程与局限
工作流程
- Slave 启动后,向 master 发送一个
sync请求,等待建立成功后,slave 会删除掉自己的数据与日志文件,等待主节点同步。 - master 接收到 slave 的
sync请求后,会触发一次 RDB 全量备份,同时收集所有接收到的修改数据的指令,然后把 RDB 和操作指令全量同步给 slave,完成第一次全量同步。 - 主从关系建立后,master 会定期向 slave 发送心跳包,确认 slave 的状态。心跳发送的间隔通过参数
repl-ping-replica-period指定,默认 10 秒。 - 只要 slave 定期向 master 回复心跳请求,master 就会持续将后续收集到的修改数据的指令传递给 slave。同时,master 会记录 offset,即已经同步给 slave 的消息偏移量。
- 如果 slave 短暂不回复 master 的心跳请求,master 就会停止向 slave 同步数据,直到 slave 重新上线后,master 从 offset 开始,继续向 slave 同步数据。这也是前面说的「部分复制」所依赖的机制。
主从复制的缺点
- 复制延时,信号衰减:所有写操作都是先在 master 上操作,然后再同步到 slave,所以数据同步一定会有延迟。当系统繁忙,或者 slave 数量增加时,这个延迟会更加严重。
- master 高可用问题:如果 master 挂了,slave 节点是不会自动切换 master 的,只能等待人工干预,重启 master 服务,或者调整主从关系,将一个 slave 切换成 master,同时将其他 slave 的主节点调整为新的 master。后续的哨兵集群,就相当于做这个人工干预的工作:检测到 master 挂了之后,自动从 slave 中选择一个节点切换成 master。
- 从数据安全性的角度,主从复制牺牲了服务高可用,但是增加了数据安全。
4. 哨兵模式(Sentinel)
为什么有哨兵模式?
Redis 主节点的能力也是有限的(当然哨兵模式也无法解决单机 Redis 性能瓶颈问题,那需要使用集群),超过了负荷就会挂掉,挂掉之后就要手动设置主节点,过于麻烦。
什么是哨兵模式?
主节点挂掉之后,通过哨兵机制来选取出新的主节点,其他从节点作为新主节点的从节点,不过整个选举过程也需要十几秒,还是会对服务造成影响。
其实整个过程只需要一个哨兵节点来完成,首先使用 Raft 算法实现选举机制,选出一个哨兵节点来完成转移和通知(选定新主节点和通知其他从节点)。
4.1 哨兵模式搭建
哨兵模式在主从复制的基础上搭建。本例使用 3 个哨兵,三台机器各部署一个(哨兵节点最好为奇数个,方便投票),端口统一使用默认的 26379,quorum 为 2。
1、准备工作
三台机器都需要放行 Redis 与哨兵的端口(vm21 的 6379 上一节已放行):
# 三台机器分别执行
[root@vm21 ~]# firewall-cmd --add-port=6379/tcp --add-port=26379/tcp --permanent
[root@vm21 ~]# firewall-cmd --reload
注意
故障转移后原主节点会变成新主节点的从节点,需要用它连接带密码的新主节点,所以主节点 192.168.1.21 也要在 redis.conf 中追加 masterauth 123456 并重启,否则会一直报 NOAUTH 错误:
[root@vm21 ~]# cat >> /data/soft/redis/etc/redis.conf << 'EOF'

# 作为从节点时连接新主节点的密码
masterauth 123456
EOF

[root@vm21 ~]# systemctl restart redis.service
2、配置哨兵
三台机器操作相同,以 vm21 为例:
# 创建哨兵配置文件
[root@vm21 ~]# cat > /data/soft/redis/etc/sentinel.conf << 'EOF'
# 哨兵端口
port 26379

# 后台启动
daemonize yes

# 哨兵密码,三个哨兵必须一致,用于哨兵之间以及客户端连接哨兵时的认证
requirepass 123456

# 哨兵日志,便于查看选主过程
logfile "/data/soft/redis/data/sentinel.log"

# 监控的主节点,最后的 2 为 quorum,代表至少 2 个哨兵认为主节点挂了才判定其客观下线
sentinel monitor mymaster 192.168.1.21 6379 2

# 主节点连接密码
sentinel auth-pass mymaster 123456
EOF
3、启动哨兵
三台机器都配置 systemd 服务并启动:
# 新建 systemd 服务文件
[root@vm21 ~]# cat > /etc/systemd/system/sentinel.service << 'EOF'
[Unit]
Description=redis.sentinel
After=network.target

[Service]
Type=forking
PIDFILE=/var/run/redis-sentinel.pid
ExecStart=/data/soft/redis/bin/redis-sentinel /data/soft/redis/etc/sentinel.conf --sentinel
ExecReload=/bin/kill -s HUP $MAINPID
ExecStop=/bin/kill -s QUIT $MAINPID
PrivateTmp=true

[Install]
WantedBy=multi-user.target
EOF

# 启动并设置开机自启
[root@vm21 ~]# systemctl daemon-reload
[root@vm21 ~]# systemctl enable --now sentinel.service
4、查看效果
# 三台机器上都能看到 redis-sentinel 进程
[root@vm21 ~]# ps -ef | grep redis
root        9863       1  0 15:53 ?        00:00:00 /data/soft/redis/bin/redis-server 0.0.0.0:6379
root        9982       1  0 16:02 ?        00:00:00 /data/soft/redis/bin/redis-sentinel *:26379 [sentinel]
root        9989    9792  0 16:02 pts/0    00:00:00 grep --color=auto redis

# 连接哨兵查看监控信息
[root@vm21 ~]# redis-cli -p 26379 -a 123456
127.0.0.1:26379> sentinel master mymaster
 1) "name"
 2) "mymaster"
 3) "ip"
 4) "192.168.1.21"
 5) "port"
 6) "6379"
...
31) "num-slaves"
32) "2"
33) "num-other-sentinels"
34) "2"
35) "quorum"
36) "2"
...
127.0.0.1:26379> exit
num-slaves 为 2、num-other-sentinels 为 2,说明两台从节点和另外两个哨兵都已被识别。
5、故障转移测试
停掉 vm21 的主节点,模拟主节点故障:
[root@vm21 ~]# systemctl stop redis.service等待 30 秒左右(受 down-after-milliseconds 控制),在 vm22 或 vm23 上查看哨兵日志,可以看到选举出新主节点(具体选哪台由哨兵根据数据新旧程度决定,本例以 192.168.1.22 为例,可以看到新的主节点被选举为 192.168.1.23):
[root@vm22 ~]# tail -f /data/soft/redis/data/sentinel.log
9957:X 23 Sep 2026 16:06:47.689 # +switch-master mymaster 192.168.1.21 6379 192.168.1.23 6379
9957:X 23 Sep 2026 16:06:47.689 * +slave slave 192.168.1.22:6379 192.168.1.22 6379 @ mymaster 192.168.1.23 6379
9957:X 23 Sep 2026 16:06:47.689 * +slave slave 192.168.1.21:6379 192.168.1.21 6379 @ mymaster 192.168.1.23 6379
查看新主节点状态:
[root@vm22 ~]# redis-cli -p 6379 -a 123456
127.0.0.1:6379> info replication
# Replication
role:slave
master_host:192.168.1.23
master_port:6379
master_link_status:up
master_last_io_seconds_ago:0
master_sync_in_progress:0
slave_read_repl_offset:100456
slave_repl_offset:100456
slave_priority:100
slave_read_only:1
replica_announced:1
connected_slaves:0
master_failover_state:no-failover
master_replid:90658572439926726bd44cec23c2d89c8a58c533
master_replid2:0bd73d01201417517084070854f7011486fb6c03
master_repl_offset:100456
second_repl_offset:44456
repl_backlog_active:1
repl_backlog_size:1048576
repl_backlog_first_byte_offset:15
repl_backlog_histlen:100442
127.0.0.1:6379> exit
再启动原主节点,哨兵会把它改成新主节点的从节点:
[root@vm21 ~]# systemctl start redis.service
[root@vm21 ~]# redis-cli -p 6379 -a 123456
127.0.0.1:6379> info replication
# Replication
role:slave
master_host:192.168.1.23
master_port:6379
master_link_status:up
master_last_io_seconds_ago:0
master_sync_in_progress:0
slave_read_repl_offset:114616
slave_repl_offset:114616
slave_priority:100
slave_read_only:1
replica_announced:1
connected_slaves:0
master_failover_state:no-failover
master_replid:90658572439926726bd44cec23c2d89c8a58c533
master_replid2:0000000000000000000000000000000000000000
master_repl_offset:114616
second_repl_offset:-1
repl_backlog_active:1
repl_backlog_size:1048576
repl_backlog_first_byte_offset:113190
repl_backlog_histlen:1427
127.0.0.1:6379> exit
其他配置补充
sentinel parallel-syncs mymaster <num>:故障转移后,同时对新主节点发起数据同步的从节点数量。为 1 时每个从节点按顺序排队一个一个复制主节点数据;为 3 时 3 个从节点同时并发复制主节点数据,不会阻塞,但存在网络和 IO 开销。该参数默认为 1,本示例保持默认即可。sentinel failover-timeout mymaster 180000:故障转移超时时间,默认 180 秒。- 如果转移超时失败,下次转移时时间为之前的 2 倍。
- 从节点变主节点时,从节点执行
slaveof no one命令一直失败的话,当时间超过 180s 时,则故障转移失败。 - 从节点复制新主节点时间超过 180s,转移失败。
sentinel down-after-milliseconds mymaster 30000:Sentinel 节点定期向主节点发 ping 命令,当超过了 30 秒时间后没有回复,可能就认定为此主节点出现故障了,该参数默认值为 30 秒。如果网络波动较大,可以适当调大,例如改成 300000,即 300 秒。
哨兵的 API
# 进入哨兵的命令模式,使用 redis-cli 进入
[root@vm21 ~]# redis-cli -p 26379 -a 123456

# 查看 redis 主节点相关信息
127.0.0.1:26379> sentinel masters
127.0.0.1:26379> sentinel master mymaster

# 查看从节点状态与相关信息
127.0.0.1:26379> sentinel slaves mymaster

# 查看 sentinel 节点集合信息(不包括当前 26379)
127.0.0.1:26379> sentinel sentinels mymaster

# 对主节点强制故障转移,没和其它节点协商
127.0.0.1:26379> sentinel failover mymaster
主观下线和客观下线
- 主观下线
哨兵节点每隔 1 秒对主节点和从节点、其它哨兵节点发送 ping 做心跳检测,当这些心跳检测时间超过 down-after-milliseconds 时,哨兵节点则认为该节点错误或下线,这叫主观下线,这可能会存在错误的判断,需要征求其他哨兵节点的信息。
- 客观下线
当某个哨兵节点首先发现主节点错误或者下线时,此时该哨兵节点会向其它哨兵节点发起询问(旧版本协议中的 sentinel is-masterdown-by-addr 指令),当超过 quorum(法定人数)个数,此时哨兵节点则认为该主节点确实有问题,这样就客观下线了。
4.2 部署建议与注意事项
- Sentinel 节点应部署在多台物理机(线上环境)。
- 至少三个且奇数个 Sentinel 节点。
- 通过以上我们知道,3 个 Sentinel 可同时监控一个主节点或多个主节点,监听 N 个主节点较多时,如果 Sentinel 出现异常,会对多个主节点有影响,同时还会造成 Sentinel 节点产生过多的网络连接,一般线上建议还是 3 个 Sentinel 监听一个主节点。
5. Redis Cluster 集群模式
为了解决单机 Redis 性能瓶颈问题,生产环境往往需要使用集群。
分布式数据库
分布式数据库把整个数据按分区规则映射到多个节点,即把数据划分到多个节点上,每个节点负责整体数据的一个子集,比如我们库有 900 条用户数据,有 3 个 Redis 节点,将 900 条分成 3 份,分别存入到 3 个 Redis 节点。
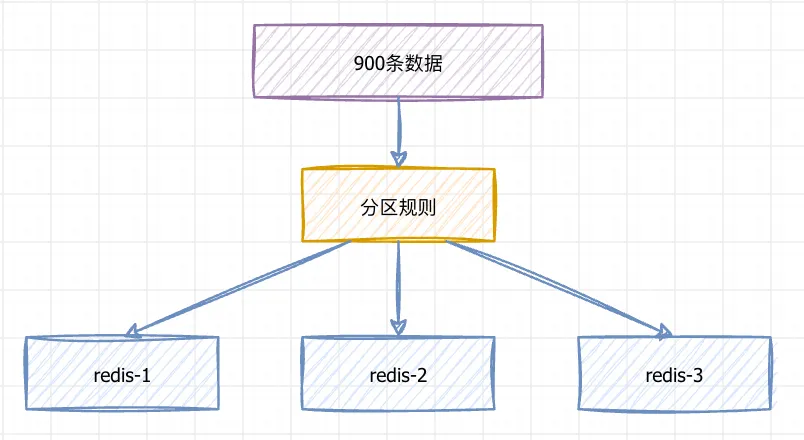
分区规则
常见的分区规则有哈希分区和顺序分区,Redis 集群支持两种(哈希分区、顺序分区),我们这里使用哈希分区,而哈希分区有三种方式(节点取余、一致性哈希分区和虚拟槽分区),Redis Cluster 采用了哈希分区的「虚拟槽分区」方式。
虚拟槽分区(槽:slot)
Redis Cluster 采用此分区,所有的键根据哈希函数 CRC16[key] & 16383 映射到 0-16383 槽内,共 16384 个槽位,每个节点维护部分槽及槽所映射的键值数据,哈希函数:Hash() = CRC16[key] & 16383。
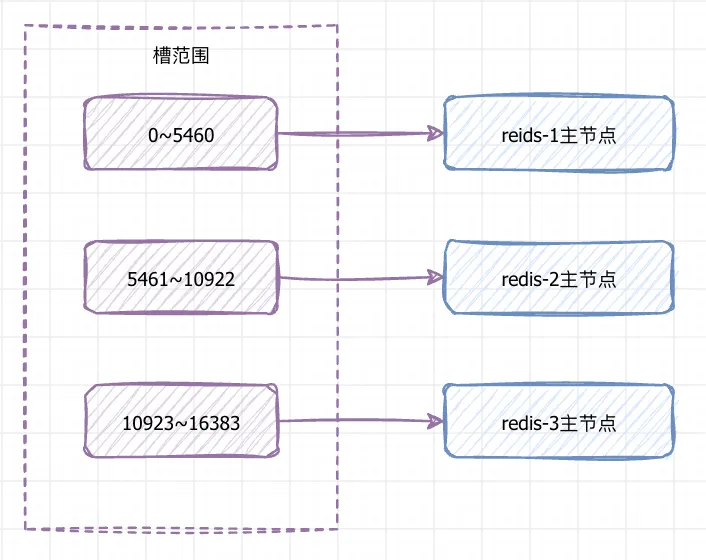
Redis 用虚拟槽分区的原因:解耦数据与节点关系,节点自身维护槽映射关系。
key 与 slot 的对应关系
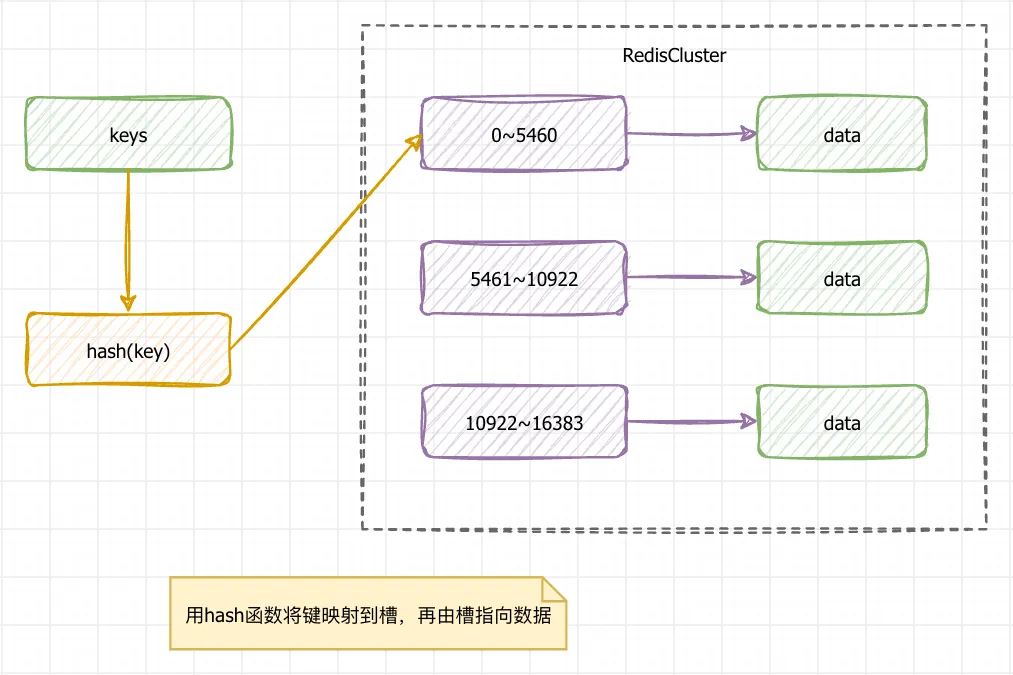
集群中每一个要写入的 key,都要先计算它所属的槽位,计算方式是 CRC16(key) mod 16384(取模运算,结果落在 0-16383 内,与上面 CRC16[key] & 16383 的位运算等价)。
计算意味着一些批量操作的复合指令(如 mset、mhset)支持得不太好:如果它们分属不同的槽位,就无法保证在一个服务上完成原子性操作。
127.0.0.1:7000> mset k1 v1 k2 v2 k3 v3
(error) CROSSSLOT Keys in request don't hash to the same slot
这也是对分布式事务的一种思考:如果这种批量指令需要分到不同的 Redis 节点上操作,那么这几个指令的原子性问题就成为了一个分布式事务问题。而分布式事务是一件非常复杂的事情,不要简单地认为用上 Seata 这样的框架就很容易解决。在大部分业务场景下,直接拒绝分布式事务是一种很好的策略。
Redis 提供了指令 CLUSTER KEYSLOT 来计算某一个 key 属于哪个 slot:
127.0.0.1:7000> CLUSTER KEYSLOT k1
(integer) 12706
另外,Redis 在计算 hash 槽时,会使用 hash tag:如果 key 中有大括号 {},那么只会根据大括号中的 hash tag 来计算槽位。
127.0.0.1:7000> CLUSTER KEYSLOT k1
(integer) 12706
127.0.0.1:7000> CLUSTER KEYSLOT roy{k1}
(integer) 12706
127.0.0.1:7000> CLUSTER KEYSLOT roy:k1
(integer) 12349
可以看到 roy{k1} 与 k1 落在同一个槽位,而 roy:k1 则不是。使用相同的 hash tag,就能保证这些数据都保存在同一个节点上,从而绕开 CROSSSLOT:
127.0.0.1:7000> mset user_{1}_name roy user_{1}_id 1 user_{1}_password 123
-> Redirected to slot [9842] located at 192.168.65.214:6382
OK
在大型 Redis 集群中,经常会出现数据倾斜的问题:大量的数据被集中存储到了集群中某一个热点 Redis 节点上,从而造成这一个节点的负载明显大于其他节点,容易造成集群的资源浪费。调整数据倾斜常见的思路是分两步:
- 调整 key 的结构,尤其是那些访问频繁的热点 key,让数据能够尽量平均地分配到各个 slot 上。
- 调整 slot 的分布,将那些数据量多、访问频繁的热点 slot 进行重新调配,让它们尽量平均地分配到不同的 Redis 节点上。
Redis Cluster 的缺陷
- 键的批量操作支持有限,比如
mset、mget,如果多个键映射在不同的槽,就不支持了。 - 键事务支持有限,当多个 key 分布在不同节点时无法使用事务,同一节点是支持事务的。
- 键是数据分区的最小粒度,不能将一个很大的键值对映射到不同的节点。
- 不支持多数据库,只有 0,
select 0。 - 主从复制结构只支持单层结构,不支持树型结构。
5.1 集群基本搭建
集群模式需要 6 个节点,本例使用三台机器,每台机器部署一个主节点和一个从节点,组成 3 主 3 从的集群。节点端口统一为:主节点 7000、从节点 7001(集群总线端口为服务端口 +10000,即 17000、17001)。
| 主机名 | 机器 | 主节点 | 从节点 |
|---|---|---|---|
| vm21 | 192.168.1.21 | 7000 | 7001 |
| vm22 | 192.168.1.22 | 7000 | 7001 |
| vm23 | 192.168.1.23 | 7000 | 7001 |
放行端口。
# 三台机器分别放行 7000、7001 以及集群总线端口 17000、17001
[root@vm21 ~]# firewall-cmd --add-port=7000/tcp --add-port=7001/tcp --add-port=17000/tcp --add-port=17001/tcp --permanent
[root@vm21 ~]# firewall-cmd --reload
准备目录与配置文件,三台机器操作相同,以 vm21 为例。
# 创建集群配置目录、数据目录、集群内部文件目录
[root@vm21 ~]# mkdir -p /data/soft/redis/etc/cluster/nodes
[root@vm21 ~]# mkdir -p /data/soft/redis/data/cluster/{data7000,data7001}

# 生成 7000 节点配置文件
[root@vm21 ~]# cat > /data/soft/redis/etc/cluster/redis7000.conf << 'EOF'
port 7000
bind 0.0.0.0
daemonize yes
dir /data/soft/redis/data/cluster/data7000
logfile "/data/soft/redis/data/cluster/data7000/redis_7000.log"
# 设置密码
requirepass 123456
# 从节点连接主节点时使用,集群内所有节点保持一致
masterauth 123456
# 开启集群模式
cluster-enabled yes
# 节点超时时间(毫秒)
cluster-node-timeout 15000
# 集群内部配置文件,节点启动后自动维护,下次启动时读取
cluster-config-file /data/soft/redis/etc/cluster/nodes/nodes-7000.conf
EOF

# 生成 7001 节点配置文件,把上面内容里的 7000 全部换成 7001
[root@vm21 ~]# cat > /data/soft/redis/etc/cluster/redis7001.conf << 'EOF'
port 7001
bind 0.0.0.0
daemonize yes
dir /data/soft/redis/data/cluster/data7001
logfile "/data/soft/redis/data/cluster/data7001/redis_7001.log"
# 设置密码
requirepass 123456
# 从节点连接主节点时使用,集群内所有节点保持一致
masterauth 123456
cluster-enabled yes
cluster-node-timeout 15000
cluster-config-file /data/soft/redis/etc/cluster/nodes/nodes-7001.conf
EOF
启动节点。
# 三台机器分别启动 7000、7001 两个节点
[root@vm21 ~]# redis-server /data/soft/redis/etc/cluster/redis7000.conf
[root@vm21 ~]# redis-server /data/soft/redis/etc/cluster/redis7001.conf
创建集群,在任意一台机器执行,前 3 个是主节点,后 3 个是从节点,--cluster-replicas 1 表示每个主节点分配 1 个从节点。命令会提示是否确认分配方案,输入 yes 回车即可。redis-cli 会尽量把从节点分配到与主节点不同的机器上,最终的主从对应关系以 --cluster check 的输出为准。集群总线端口(服务端口 +10000)也会用同一个密码做认证,所以各节点的密码必须保持一致。
[root@vm21 ~]# redis-cli --cluster create \
  192.168.1.21:7000 192.168.1.22:7000 192.168.1.23:7000 \
  192.168.1.21:7001 192.168.1.22:7001 192.168.1.23:7001 \
  --cluster-replicas 1 -a 123456

Warning: Using a password with '-a' or '-u' option on the command line interface may not be safe.
>>> Performing hash slots allocation on 6 nodes...
Master[0] -> Slots 0 - 5460
Master[1] -> Slots 5461 - 10922
Master[2] -> Slots 10923 - 16383
Adding replica 192.168.1.22:7001 to 192.168.1.21:7000
Adding replica 192.168.1.23:7001 to 192.168.1.22:7000
Adding replica 192.168.1.21:7001 to 192.168.1.23:7000
M: 35e961b8058c8149375b0a772c8d80e18f8f3206 192.168.1.21:7000
   slots:[0-5460] (5461 slots) master
M: 7e073465a3aab69116baf293d50d66e7351906a0 192.168.1.22:7000
   slots:[5461-10922] (5462 slots) master
M: 07b7feae731701d84195bb8ee3daa4e237bbe240 192.168.1.23:7000
   slots:[10923-16383] (5461 slots) master
S: e283c55d38d88c410462bd3c312f1d5bc376b555 192.168.1.21:7001
   replicates 07b7feae731701d84195bb8ee3daa4e237bbe240
S: c4503b92378a7de45e2a2e0487d4bd59af5b6cc2 192.168.1.22:7001
   replicates 35e961b8058c8149375b0a772c8d80e18f8f3206
S: e108451f15a975a1cd0b6e178e28d3aaeb9c18b5 192.168.1.23:7001
   replicates 7e073465a3aab69116baf293d50d66e7351906a0
Can I set the above configuration? (type 'yes' to accept): yes
>>> Nodes configuration updated
>>> Assign a different config epoch to each node
>>> Sending CLUSTER MEET messages to join the cluster
Waiting for the cluster to join
.
>>> Performing Cluster Check (using node 192.168.1.21:7000)
M: 35e961b8058c8149375b0a772c8d80e18f8f3206 192.168.1.21:7000
   slots:[0-5460] (5461 slots) master
   1 additional replica(s)
M: 07b7feae731701d84195bb8ee3daa4e237bbe240 192.168.1.23:7000
   slots:[10923-16383] (5461 slots) master
   1 additional replica(s)
S: e283c55d38d88c410462bd3c312f1d5bc376b555 192.168.1.21:7001
   slots: (0 slots) slave
   replicates 07b7feae731701d84195bb8ee3daa4e237bbe240
S: c4503b92378a7de45e2a2e0487d4bd59af5b6cc2 192.168.1.22:7001
   slots: (0 slots) slave
   replicates 35e961b8058c8149375b0a772c8d80e18f8f3206
S: e108451f15a975a1cd0b6e178e28d3aaeb9c18b5 192.168.1.23:7001
   slots: (0 slots) slave
   replicates 7e073465a3aab69116baf293d50d66e7351906a0
M: 7e073465a3aab69116baf293d50d66e7351906a0 192.168.1.22:7000
   slots:[5461-10922] (5462 slots) master
   1 additional replica(s)
[OK] All nodes agree about slots configuration.
>>> Check for open slots...
>>> Check slots coverage...
[OK] All 16384 slots covered.
集群测试千万不要忘记加 -c,不然进入的不是集群环境,同时日志中的效果有重定向是因为 set username zhangsan 时计算键 username 的槽位对应 14315 槽位,归 192.168.1.23:7000 节点管理,那么重定向到该节点将数据存储,当然,这也代表我们集群没问题。
# -c 表示以集群模式连接,遇到重定向会自动跟随
[root@vm21 ~]# redis-cli -h 192.168.1.21 -p 7000 -c -a 123456
192.168.1.21:7000> set username zhangsan
-> Redirected to slot [14315] located at 192.168.1.23:7000
OK
192.168.1.23:7000> get username
"zhangsan"
集群状态查看
[root@vm21 ~]# redis-cli --cluster check 192.168.1.21:7000 -a 123456
Warning: Using a password with '-a' or '-u' option on the command line interface may not be safe.
192.168.1.21:7000 (35e961b8...) -> 0 keys | 5461 slots | 1 slaves.
192.168.1.23:7000 (07b7feae...) -> 1 keys | 5461 slots | 1 slaves.
192.168.1.22:7000 (7e073465...) -> 0 keys | 5462 slots | 1 slaves.
[OK] 1 keys in 3 masters.
0.00 keys per slot on average.
>>> Performing Cluster Check (using node 192.168.1.21:7000)
M: 35e961b8058c8149375b0a772c8d80e18f8f3206 192.168.1.21:7000
   slots:[0-5460] (5461 slots) master
   1 additional replica(s)
M: 07b7feae731701d84195bb8ee3daa4e237bbe240 192.168.1.23:7000
   slots:[10923-16383] (5461 slots) master
   1 additional replica(s)
S: e283c55d38d88c410462bd3c312f1d5bc376b555 192.168.1.21:7001
   slots: (0 slots) slave
   replicates 07b7feae731701d84195bb8ee3daa4e237bbe240
S: c4503b92378a7de45e2a2e0487d4bd59af5b6cc2 192.168.1.22:7001
   slots: (0 slots) slave
   replicates 35e961b8058c8149375b0a772c8d80e18f8f3206
S: e108451f15a975a1cd0b6e178e28d3aaeb9c18b5 192.168.1.23:7001
   slots: (0 slots) slave
   replicates 7e073465a3aab69116baf293d50d66e7351906a0
M: 7e073465a3aab69116baf293d50d66e7351906a0 192.168.1.22:7000
   slots:[5461-10922] (5462 slots) master
   1 additional replica(s)
[OK] All nodes agree about slots configuration.
>>> Check for open slots...
>>> Check slots coverage...
[OK] All 16384 slots covered.
(节点 id 以实际为准)从这里面可以看到 3 个主节点和分别分配的槽位,对照上面的 replicates 信息,跨机的主从对应关系为:
- 192.168.1.21:7000 的从节点为 192.168.1.22:7001
- 192.168.1.22:7000 的从节点为 192.168.1.23:7001
- 192.168.1.23:7000 的从节点为 192.168.1.21:7001
5.2 集群扩缩容(新增 / 删除节点)
5.2.1 新增节点
在 vm21 上准备两个节点配置文件 redis7002.conf、redis7003.conf,并放行 7002、7003 及集群总线端口 17002、17003。
# 基于 7000 节点的配置文件生成 7002、7003 节点配置
[root@vm21 ~]# mkdir -p /data/soft/redis/data/cluster/{data7002,data7003}
[root@vm21 ~]# sed 's/7000/7002/g' /data/soft/redis/etc/cluster/redis7000.conf > /data/soft/redis/etc/cluster/redis7002.conf
[root@vm21 ~]# sed 's/7000/7003/g' /data/soft/redis/etc/cluster/redis7000.conf > /data/soft/redis/etc/cluster/redis7003.conf

# 放行端口
[root@vm21 ~]# firewall-cmd --add-port=7002/tcp --add-port=7003/tcp --add-port=17002/tcp --add-port=17003/tcp --permanent
[root@vm21 ~]# firewall-cmd --reload
分别把这两个服务启动起来。
[root@vm21 ~]# redis-server /data/soft/redis/etc/cluster/redis7002.conf
[root@vm21 ~]# redis-server /data/soft/redis/etc/cluster/redis7003.conf
将 7002 加入到集群主节点。
[root@vm21 ~]# redis-cli --cluster add-node 192.168.1.21:7002 192.168.1.21:7000 -a 123456
Warning: Using a password with '-a' or '-u' option on the command line interface may not be safe.
>>> Adding node 192.168.1.21:7002 to cluster 192.168.1.21:7000
>>> Performing Cluster Check (using node 192.168.1.21:7000)
M: 35e961b8058c8149375b0a772c8d80e18f8f3206 192.168.1.21:7000
   slots:[0-5460] (5461 slots) master
   1 additional replica(s)
M: 07b7feae731701d84195bb8ee3daa4e237bbe240 192.168.1.23:7000
   slots:[10923-16383] (5461 slots) master
   1 additional replica(s)
S: e283c55d38d88c410462bd3c312f1d5bc376b555 192.168.1.21:7001
   slots: (0 slots) slave
   replicates 07b7feae731701d84195bb8ee3daa4e237bbe240
S: c4503b92378a7de45e2a2e0487d4bd59af5b6cc2 192.168.1.22:7001
   slots: (0 slots) slave
   replicates 35e961b8058c8149375b0a772c8d80e18f8f3206
S: e108451f15a975a1cd0b6e178e28d3aaeb9c18b5 192.168.1.23:7001
   slots: (0 slots) slave
   replicates 7e073465a3aab69116baf293d50d66e7351906a0
M: 7e073465a3aab69116baf293d50d66e7351906a0 192.168.1.22:7000
   slots:[5461-10922] (5462 slots) master
   1 additional replica(s)
[OK] All nodes agree about slots configuration.
>>> Check for open slots...
>>> Check slots coverage...
[OK] All 16384 slots covered.
>>> Getting functions from cluster
>>> Send FUNCTION LIST to 192.168.1.21:7002 to verify there is no functions in it
>>> Send FUNCTION RESTORE to 192.168.1.21:7002
>>> Send CLUSTER MEET to node 192.168.1.21:7002 to make it join the cluster.
[OK] New node added correctly.
这时候可以查看一下 redis-cli --cluster check 192.168.1.21:7002 -a 123456 状态,7002 节点已经加入集群,并且是一个主节点,但是没有分配槽位,此时无法进行存储数据。
M: 8891d8c5557e77641a52ed9c6b61dc228bb34264 192.168.1.21:7002
   slots: (0 slots) master
将 7003 加入到集群,并且作为 7002 的从节点。
[root@vm21 ~]# redis-cli --cluster add-node 192.168.1.21:7003 192.168.1.21:7002 --cluster-slave --cluster-master-id 8891d8c5557e77641a52ed9c6b61dc228bb34264 -a 123456这时候可以查看一下 redis-cli --cluster check 192.168.1.21:7003 -a 123456 状态,已经成为了 7002 的从节点,但是此时 7002 还是没有分配槽位,还是无法存储数据。
[root@vm21 ~]# redis-cli --cluster check 192.168.1.21:7003 -a 123456
Warning: Using a password with '-a' or '-u' option on the command line interface may not be safe.
192.168.1.21:7000 (35e961b8...) -> 0 keys | 5461 slots | 1 slaves.
192.168.1.23:7000 (07b7feae...) -> 1 keys | 5461 slots | 1 slaves.
192.168.1.21:7002 (8891d8c5...) -> 0 keys | 0 slots | 1 slaves.
192.168.1.22:7000 (7e073465...) -> 0 keys | 5462 slots | 1 slaves.
[OK] 1 keys in 4 masters.
0.00 keys per slot on average.
>>> Performing Cluster Check (using node 192.168.1.21:7003)
S: 046dd5054b147d6144ae17d3edf99231978777bb 192.168.1.21:7003
   slots: (0 slots) slave
   replicates 8891d8c5557e77641a52ed9c6b61dc228bb34264
M: 35e961b8058c8149375b0a772c8d80e18f8f3206 192.168.1.21:7000
   slots:[0-5460] (5461 slots) master
   1 additional replica(s)
S: c4503b92378a7de45e2a2e0487d4bd59af5b6cc2 192.168.1.22:7001
   slots: (0 slots) slave
   replicates 35e961b8058c8149375b0a772c8d80e18f8f3206
M: 07b7feae731701d84195bb8ee3daa4e237bbe240 192.168.1.23:7000
   slots:[10923-16383] (5461 slots) master
   1 additional replica(s)
S: e283c55d38d88c410462bd3c312f1d5bc376b555 192.168.1.21:7001
   slots: (0 slots) slave
   replicates 07b7feae731701d84195bb8ee3daa4e237bbe240
M: 8891d8c5557e77641a52ed9c6b61dc228bb34264 192.168.1.21:7002
   slots: (0 slots) master
   1 additional replica(s)
S: e108451f15a975a1cd0b6e178e28d3aaeb9c18b5 192.168.1.23:7001
   slots: (0 slots) slave
   replicates 7e073465a3aab69116baf293d50d66e7351906a0
M: 7e073465a3aab69116baf293d50d66e7351906a0 192.168.1.22:7000
   slots:[5461-10922] (5462 slots) master
   1 additional replica(s)
[OK] All nodes agree about slots configuration.
>>> Check for open slots...
>>> Check slots coverage...
[OK] All 16384 slots covered.
给新加的主节点 7002 分配槽位,分配 1000 个槽位。
[root@vm21 ~]# redis-cli --cluster reshard 192.168.1.21:7000 -a 123456

# 中途会提示几个选项
How many slots do you want to move (from 1 to 16384)? 1000

# 转移到新节点 id(即新增主节点 id)
What is the receiving node ID? 8891d8c5557e77641a52ed9c6b61dc228bb34264

# 从哪里分配槽位,all 代表所有主节点分配,也可以输入 cluster-master-id
Source node #1: all

# 是否继续分配:yes
Do you want to proceed with the proposed reshard plan (yes/no)? yes
然后再次 redis-cli --cluster check 192.168.1.21:7003 -a 123456 查看状态,发现槽位已经分配。
M: 8891d8c5557e77641a52ed9c6b61dc228bb34264 192.168.1.21:7002
   slots:[0-332],[5461-5794],[10923-11255] (1000 slots) master
   1 additional replica(s)
5.2.2 删除节点
首先需要删除从节点,不然集群会认为主节点故障,从而让从节点变成主节点。
查找到 7003 从节点 id,然后执行命令。
[root@vm21 ~]# redis-cli --cluster del-node 192.168.1.21:7003 046dd5054b147d6144ae17d3edf99231978777bb -a 123456
Warning: Using a password with '-a' or '-u' option on the command line interface may not be safe.
>>> Removing node 046dd5054b147d6144ae17d3edf99231978777bb from cluster 192.168.1.21:7003
>>> Sending CLUSTER FORGET messages to the cluster...
>>> Sending CLUSTER RESET SOFT to the deleted node.
将要删除的主节点的槽位分配给其他主节点,与增加类似,如果不移出会导致数据丢失。
[root@vm21 ~]# redis-cli --cluster reshard 192.168.1.21:7002 -a 123456

How many slots do you want to move (from 1 to 16384)? 1000

# 接收槽位的节点 id,这里给 192.168.1.23:7000
What is the receiving node ID? 07b7feae731701d84195bb8ee3daa4e237bbe240

Source node #1: 8891d8c5557e77641a52ed9c6b61dc228bb34264
Source node #2: done

Do you want to proceed with the proposed reshard plan (yes/no)? yes
槽位数据转移给别的主节点后,删除节点,删除后可以 redis-cli --cluster check 192.168.1.21:7000 -a 123456 查看集群信息是否正常。
[root@vm21 ~]# redis-cli --cluster del-node 192.168.1.21:7002 8891d8c5557e77641a52ed9c6b61dc228bb34264 -a 1234565.3 集群节点通信与选举
节点之间采用 Gossip 协议进行通信,Gossip 协议就是指节点彼此之间不断通信交换信息。当主从角色变化或新增节点,彼此通过 ping/pong 进行通信知道全部节点的最新状态并达到集群状态一致。
5.3.1 Gossip 协议
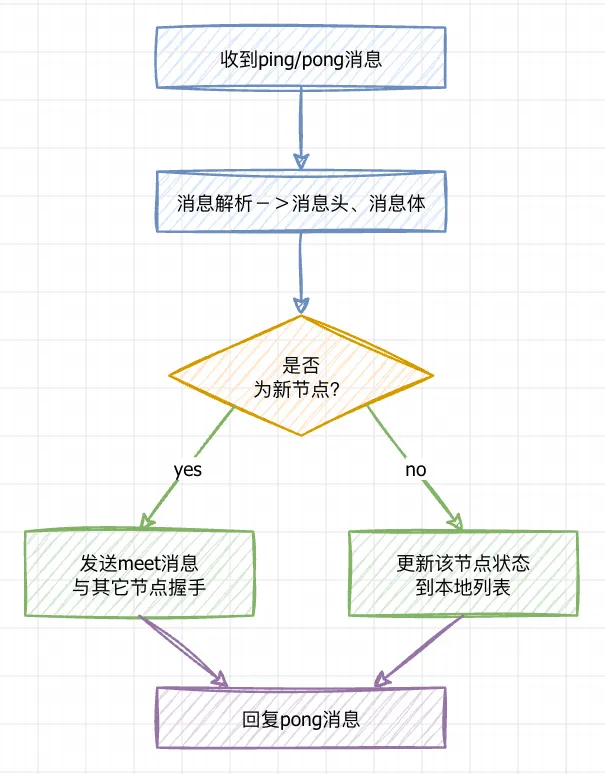
Gossip 协议的主要职责就是信息交换,信息交换的载体就是节点之间彼此发送的 Gossip 消息,常用的 Gossip 消息有 ping 消息、pong 消息、meet 消息、fail 消息。
- meet 消息:用于通知新节点加入,消息发送者通知接收者加入到当前集群,meet 消息通信完后,接收节点会加入到集群中,并进行周期性 ping pong 交换。
- ping 消息:集群内交换最频繁的消息,集群内每个节点每秒向其它节点发 ping 消息,用于检测节点是否在线和状态信息,ping 消息发送时封装自身节点和其他节点的状态数据。
- pong 消息:当接收到 ping、meet 消息时,作为响应消息返回给发送方,用来确认正常通信,pong 消息也封装了自身状态数据。
- fail 消息:当节点判定集群内的另一节点下线时,会向集群内广播一个 fail 消息。
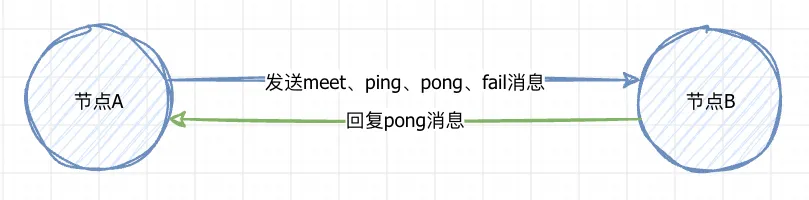
Gossip 协议的主要作用有:节点间发送心跳,确认其他节点的存在;通知其他节点新节点的加入或已经下线的节点;通过反馈机制更新节点的状态,如权重、过期时间等。
Gossip 集群是去中心化的,各个节点彼此之间通过 Gossip 协议互相通信,保证集群内部各个节点最终能够达成统一。但 Gossip 协议更新元数据并不是同时在集群内部同步,而是陆陆续续请求到所有节点上,因此 Gossip 协议的数据统一是有一定延迟的。
Gossip 协议最大的好处在于,即使集群节点的数量增加,每个节点的负载也不会增加很多,几乎是恒定的,因此在 Redis 集群中,哪怕构建非常多的节点,也不会对服务性能造成很大的影响。但 Gossip 协议的数据同步是有延迟的,如果集群节点太多,数据同步的延迟时间也会增加,这对于 Redis 是不合适的,因此通常不建议构建太大的 Redis 集群。
需要留意的是,Redis 集群中每个节点都有一个专门用于节点之间进行 Gossip 通信的端口,就是自己提供服务的端口 +10000。因此部署 Redis 集群时要注意防火墙配置,不要把这个端口屏蔽了。
消息解析过程
5.3.2 集群选举流程
当 slave 发现自己的 master 变为 FAIL 状态时,便尝试进行 Failover,以期成为新的 master。由于挂掉的 master 可能会有多个 slave,从而存在多个 slave 竞争成为 master 节点的过程,其过程如下:
- slave 发现自己的 master 变为 FAIL。
- 将自己记录的集群 currentEpoch 加 1,并广播
FAILOVER_AUTH_REQUEST信息(currentEpoch 可以理解为选举周期,通过cluster info指令可以看到)。 - 其他节点收到该信息,只有 master 响应,判断请求者的合法性,并发送
FAILOVER_AUTH_ACK,对每一个 epoch 只发送一次 ack。 - 尝试 failover 的 slave 收集 master 返回的
FAILOVER_AUTH_ACK。 - slave 收到超过半数 master 的 ack 后变成新 master。这里也解释了集群为什么至少需要三个主节点:如果只有两个,当其中一个挂了,只剩一个主节点是不能选举成功的。
- slave 广播 Pong 消息通知其他集群节点。
从节点并不是在主节点一进入 FAIL 状态就马上尝试发起选举,而是有一定延迟。一定的延迟确保等待 FAIL 状态在集群中传播完成,slave 如果立即尝试选举,其它 masters 或许尚未意识到 FAIL 状态,可能会拒绝投票。
延迟计算公式:DELAY = 500ms + random(0 ~ 500ms) + SLAVE_RANK * 1000ms。
SLAVE_RANK 表示此 slave 已经从 master 复制数据的总量的 rank。Rank 越小代表已复制的数据越新。这种方式下,持有最新数据的 slave 将会首先发起选举(理论上)。
5.4 集群的数据安全性
首先,在 Redis 集群相对比较稳定的时候,Redis 集群是能够保证数据安全的。因为集群中每个 master 都是可以配置 slave 从节点的,这些 slave 节点会即时备份 master 的数据,在 master 宕机时,slave 会自动切换成 master,继续提供服务。
在 Redis 的配置文件中,有两个参数用来保证每个 master 必须有健康的 slave 进行备份:
# It is possible for a master to stop accepting writes if there are less than
# N replicas connected, having a lag less or equal than M seconds.
#
# The N replicas need to be in "online" state.
# The lag in seconds, that must be <= the specified value, is calculated from
# the last ping received from the replica, that is usually sent every second.
# This option does not GUARANTEE that N replicas will accept the write, but
# will limit the window of exposure for lost writes in case not enough replicas
# are available, to the specified number of seconds.
# For example to require at least 3 replicas with a lag <= 10 seconds use:
#
# min-replicas-to-write 3
# min-replicas-max-lag 10
#
# Setting one or the other to 0 disables the feature.
#
# By default min-replicas-to-write is set to 0 (feature disabled) and
# min-replicas-max-lag is set to 10.min-replicas-to-write:至少要连接的从节点数量,低于该值时 master 停止接受写请求。默认为 0,表示不启用该限制。min-replicas-max-lag:从节点的最大允许延迟(秒),延迟由最后一次收到从节点 ping 的时间计算。默认值为 10。
这两个参数不能保证从节点一定接受写入,但可以把「从节点不足时写请求可能丢失」的时间窗口限制在指定的秒数内。
由于 Redis 集群的 Gossip 协议在同步元数据时不保证强一致性,这意味着在特定的条件下,Redis 集群可能会丢掉一些被系统收到的写入请求命令。这些特定条件通常都比较苛刻,概率比较小,比如网络抖动产生的脑裂问题。
在企业中,有良好的运维支持,通常可以认为 Redis 集群的数据是安全的。