
Redis分布式锁
1. 为什么需要分布式锁
在单机应用里,遇到并发问题,用 synchronized 或者 ReentrantLock 就能把多个线程挡在临界区外面。但现在的系统基本都是多实例部署,请求经过负载均衡后会被分发到不同的 JVM 进程,本地锁的互斥范围只在一个 JVM 进程内,跨进程就失效了。
1.1 本地锁的局限
以电商秒杀扣库存为例,假设库存放在 Redis 里,扣减代码如下:
// 本地锁:只能保证当前 JVM 内的线程互斥
public void deductStock() {
    synchronized (this) {
        String stock = stringRedisTemplate.opsForValue().get("stock:10001");
        if (stock != null && Integer.parseInt(stock) > 0) {
            stringRedisTemplate.opsForValue().decrement("stock:10001");
        }
    }
}
单实例部署时这段代码没有问题;一旦部署两个实例,请求被分发到实例 A 和实例 B,就会出现超卖:
- 实例 A 的线程和实例 B 的线程同时读到库存 100。
- 两边各自
synchronized加锁成功,因为锁的对象不是同一个。 - 各自扣减 1 后写回 99,最终卖出了 2 件,库存却只减了 1。
本地锁锁不住跨进程的并发,需要一把「所有实例都能看到的锁」,这就是分布式锁。
| 对比项 | 本地锁 | 分布式锁 |
|---|---|---|
| 互斥范围 | 单个 JVM 进程内的线程 | 所有实例,跨进程、跨机器 |
| 实现方式 | synchronized、ReentrantLock | Redis、ZooKeeper、数据库等 |
| 适用场景 | 单机应用 | 集群、微服务架构 |
1.2 分布式锁要满足哪些条件
| 条件 | 说明 |
|---|---|
| 互斥 | 同一时刻只能有一个客户端持有锁 |
| 防死锁 | 客户端宕机后锁能自动释放,不能一直被占用 |
| 锁归属 | 谁加的锁只能由谁释放,不能误删别人的锁 |
| 可重入 | 同一个线程可以重复获取同一把锁 |
| 高性能 | 加锁、解锁不能成为新的性能瓶颈 |
| 高可用 | 锁服务本身不能是单点,否则锁服务一挂,整个业务都被阻塞 |
1.3 用 Redis 手写一把分布式锁
Redis 的 SETNX 天生适合做这件事:key 不存在才设置成功,返回 1 表示抢到锁,返回 0 表示锁已被占用。
// 最简单的写法:抢锁 + 释放锁
Boolean locked = stringRedisTemplate.opsForValue().setIfAbsent("lock:stock:10001", "1");
if (Boolean.TRUE.equals(locked)) {
    try {
        // 业务操作:扣减库存
    } finally {
        stringRedisTemplate.delete("lock:stock:10001");
    }
}
这段代码只是雏形,真正上线前要解决四个问题。
1、程序崩溃导致死锁
释放锁之前程序崩溃(或者机器断电),锁永远不会被释放,其他请求全部被卡死。解决办法是给锁加过期时间,并且用一条原子指令同时完成「不存在才设置」和「设置过期时间」。
SET lock:stock:10001 1 EX 30 NX对应 Java 中的 setIfAbsent(key, value, timeout, unit)。
2、误删别人的锁
业务执行时间超过了过期时间,锁提前释放,其他线程拿到了锁;此时线程 A 执行完业务,delete 掉的是线程 B 的锁。解决办法是把线程标识(如 uuid:threadId)作为 value,释放前先判断锁是不是自己的,判断和删除必须用 Lua 脚本保证原子性。
-- KEYS[1]:锁的 key,ARGV[1]:当前线程标识
-- 锁是自己的才删除
if (redis.call('get', KEYS[1]) == ARGV[1]) then
    return redis.call('del', KEYS[1]);
end;
return 0;
String clientId = UUID.randomUUID() + ":" + Thread.currentThread().threadId();
Boolean locked = stringRedisTemplate.opsForValue()
.setIfAbsent("lock:stock:10001", clientId, 30, TimeUnit.SECONDS);
if (Boolean.TRUE.equals(locked)) {
try {
// 业务操作:扣减库存
} finally {
// 用 Lua 脚本释放锁,判断 + 删除原子执行
stringRedisTemplate.execute(new DefaultRedisScript<>(RELEASE_SCRIPT, Long.class),
Collections.singletonList("lock:stock:10001"), clientId);
}
}3、锁提前过期
业务还没执行完锁就过期了,互斥性同样会被破坏,需要给锁做自动续期:后台起一个定时任务,业务没结束就定期把过期时间续上。
4、可重入
同一个线程重复加锁时,不应该被自己的锁挡住,需要记录重入次数。
面试怎么回答?
手写 Redis 分布式锁的演进思路是:SETNX 加锁 → SET NX EX 原子加锁并设置过期时间 → value 存 uuid:threadId、用 Lua 脚本校验归属后释放 → 后台定时任务续期 → Hash 结构记录重入次数。要处理的问题越来越多,生产环境一般直接用 Redisson。
2. Redisson
Redisson 是 Redis 生态中常用的 Java 客户端,在 Redis 的基础上实现了一系列分布式对象,包括分布式锁、分布式集合、分布式队列、布隆过滤器等,其中最常用的就是分布式锁。前面提到的过期续期、可重入、原子释放、等待唤醒等问题,Redisson 都已经封装好了。
2.1 使用
1、引入依赖
<dependency>
    <groupId>org.redisson</groupId>
    <artifactId>redisson-spring-boot-starter</artifactId>
    <!-- Spring Boot 3.5 配套,内置 redisson-spring-data-35 -->
    <version>3.52.0</version>
</dependency>
提示
redisson-spring-boot-starter 会自动读取 SpringBoot 的 spring.data.redis 配置,不需要再写连接配置。需要注意的是,starter 内置的 redisson-spring-data-XX 必须与本项目的 Spring Data Redis 线匹配:Spring Boot 3.4 对应 -34,3.5 对应 -35;不匹配时(比如 Redisson 4.x 默认带 -41)要排除内置模块再显式引入对应版本,否则启动会报 NoClassDefFoundError。另外,Spring Boot 3.5 是 3.x 的最后一代,OSS 支持已于 2026 年 6 月结束,有条件建议升级到 Spring Boot 4 + Redisson 4.x。
2、配置 RedissonClient
如果使用 starter,直接注入 RedissonClient 即可;如果引入的是 redisson 核心包,则需要手动创建:
@Configuration
public class RedissonConfig {

    @Bean(destroyMethod = "shutdown")
    public RedissonClient redissonClient() {
        Config config = new Config();
        // 单机模式
        config.useSingleServer()
                .setAddress("redis://127.0.0.1:6379")
                .setPassword("123456");
        // 哨兵模式用 useSentinelServers(),集群模式用 useClusterServers()
        return Redisson.create(config);
    }
}
注意
RedissonClient 内部维护了 Netty 线程池和连接,是重量级对象,一个应用只需要一个实例(交给 Spring 单例管理即可),不要每次加锁都去创建。
3、加锁与释放
@Resource
private RedissonClient redissonClient;

public void deductStock() {
    // 一把锁对应一个 key
    RLock lock = redissonClient.getLock("lock:stock:10001");
    // 加锁:阻塞等待直到成功,默认 30 秒过期,自动续期
    lock.lock();
    try {
        // 业务操作:扣减库存
    } finally {
        // 释放锁:只有锁的持有者才能释放
        if (lock.isLocked() && lock.isHeldByCurrentThread()) {
            lock.unlock();
        }
    }
}
常用 API:
| 方法 | 说明 |
|---|---|
lock() | 阻塞式加锁,直到成功;默认租期 30 秒,自动续期 |
lock(leaseTime, unit) | 指定租期,到期自动释放,不自动续期 |
tryLock() | 非阻塞,尝试一次,成功返回 true,失败立即返回 false |
tryLock(waitTime, leaseTime, unit) | 在 waitTime 内等待,超时返回 false |
unlock() | 释放锁,重入次数减到 0 时真正删除锁 |
isHeldByCurrentThread() | 当前线程是否持有该锁 |
4、可重入
同一个线程可以重复加锁,每 lock() 一次重入次数加 1,unlock() 次数要一一对应,减到 0 时锁才真正释放:
RLock lock = redissonClient.getLock("lock:stock:10001");
lock.lock();
lock.lock(); // 重入,重入次数 +1
try {
    // 业务操作
} finally {
    lock.unlock(); // 重入次数 -1
    lock.unlock(); // 重入次数减到 0,锁真正释放
}
5、其他锁类型
| 锁 | 获取方式 | 说明 |
|---|---|---|
| 可重入锁 | getLock(key) | 最常用,同一线程可重复加锁 |
| 公平锁 | getFairLock(key) | 按请求先后顺序获取锁,避免饥饿 |
| 读写锁 | getReadWriteLock(key) | 读读不互斥,读写、写写互斥 |
| 联锁 | getMultiLock(lock...) | 多把锁一起加,用于实现红锁语义 |
2.2 原理
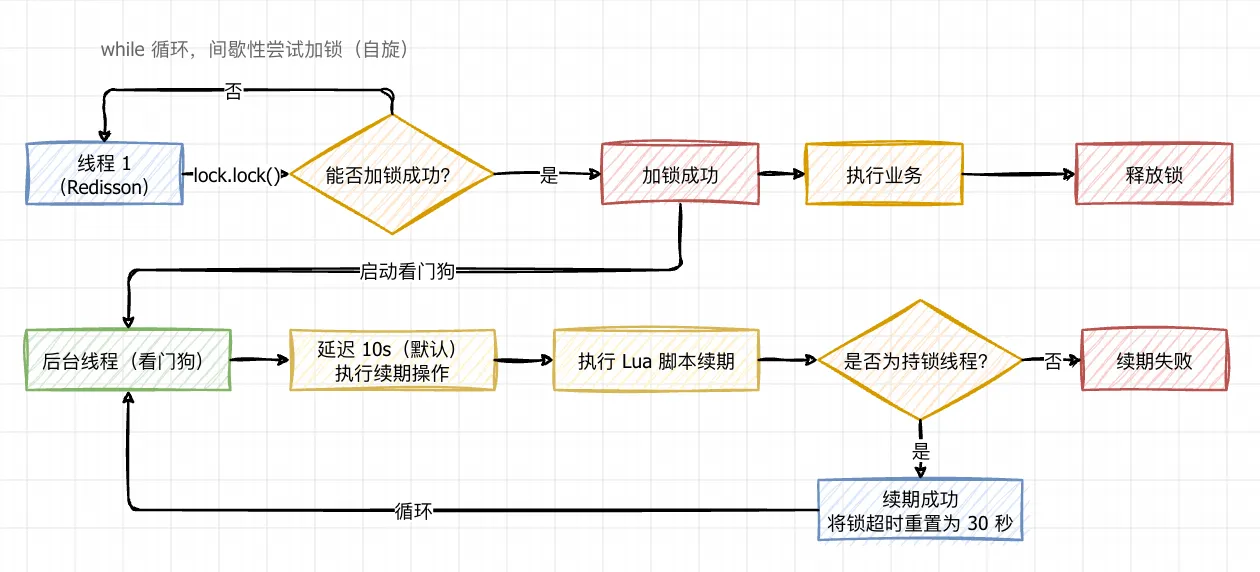
2.2.1 加锁
Redisson 加锁的核心是一段 Lua 脚本:
-- KEYS[1]:锁的 key,如 lock:stock:10001
-- ARGV[1]:锁的过期时间,默认 30000 毫秒
-- ARGV[2]:客户端标识,格式为 uuid:threadId
-- 锁不存在,或者锁的持有者就是当前线程(可重入)
if ((redis.call('exists', KEYS[1]) == 0) or (redis.call('hexists', KEYS[1], ARGV[2]) == 1)) then
    redis.call('hincrby', KEYS[1], ARGV[2], 1);
    redis.call('pexpire', KEYS[1], ARGV[1]);
    return nil;
end;
-- 锁被其他线程持有,返回剩余过期时间,方便后续等待
return redis.call('pttl', KEYS[1]);
脚本执行完后,Redis 里会多出一个 Hash 结构的锁:
# key 是锁的名字,field 是 uuid:threadId,value 是重入次数
127.0.0.1:6379> hgetall lock:stock:10001
1) "0f3d1b1a-8c1e-4c1a-9d1e-2b7f3a6c9e01:35"
2) "1"
可以看到几个设计点:
- 用 Hash 而不是 String,就是为了记录重入次数。
- field 里的 uuid 标识客户端、threadId 标识线程,做到「谁加锁谁释放」,释放时不会误删别人的锁。
- 加锁的同时用
pexpire设置过期时间(默认 30 秒,由lockWatchdogTimeout控制),防止客户端宕机后锁无法释放。
2.2.2 锁续期
业务执行时间是不确定的,如果锁在业务执行完之前就过期了,其他线程就能拿到锁,互斥性被破坏。Redisson 的解决办法是「看门狗」(WatchDog):加锁成功后注册一个定时任务,每隔租期的 1/3(默认 30 / 3 = 10 秒)检查一次,如果当前线程还持有锁,就把锁的过期时间重新设置为 30 秒,直到 unlock() 释放锁时才取消定时任务。
续期同样是一段 Lua 脚本:
-- 锁还是当前线程持有的,就重新设置过期时间
if (redis.call('hexists', KEYS[1], ARGV[2]) == 1) then
    redis.call('pexpire', KEYS[1], ARGV[1]);
    return 1;
end;
return 0;
注意
只有调用 lock()、tryLock()(不指定 leaseTime)时才会自动续期。如果调用的是 lock(10, TimeUnit.SECONDS) 或者 tryLock(waitTime, leaseTime, unit) 指定了租期,Redisson 认为你能自己控制业务执行时间,不会启动看门狗,锁到期后自动释放。
2.2.3 解锁
解锁同样是一段 Lua 脚本:
-- KEYS[1]:锁的 key
-- KEYS[2]:释放消息的频道,redisson_lock__channel:{锁的 key}
-- ARGV[1]:释放消息,固定为 0
-- ARGV[2]:锁的过期时间
-- ARGV[3]:客户端标识,uuid:threadId
-- 锁不是当前线程持有的,直接返回,不能释放别人的锁
if (redis.call('hexists', KEYS[1], ARGV[3]) == 0) then
    return nil;
end;
-- 重入次数 -1
local counter = redis.call('hincrby', KEYS[1], ARGV[3], -1);
if (counter > 0) then
    -- 还有重入,刷新过期时间
    redis.call('pexpire', KEYS[1], ARGV[2]);
    return 0;
else
    -- 重入次数减到 0,删除锁并发布释放消息,唤醒等待的线程
    redis.call('del', KEYS[1]);
    redis.call('publish', KEYS[2], ARGV[1]);
    return 1;
end;
2.2.4 加锁失败的等待机制
加锁失败时,Redisson 不会一直自旋消耗 CPU,而是借助 Redis 的发布订阅(pub/sub)实现等待唤醒:
- 加锁失败,拿到锁的剩余过期时间(脚本返回的
pttl)。 - 订阅释放消息频道
redisson_lock__channel:{锁的 key},然后阻塞等待。 - 锁的持有者释放锁时,向该频道
publish一条消息,等待的线程被唤醒,重新尝试加锁。 - 如果等待时间超过了
tryLock指定的waitTime,直接返回失败。
整个加锁、续期、等待、解锁的流程,源码入口在 RedissonLock#lock() → tryAcquire() → tryAcquireAsync() → tryLockInnerAsync(),感兴趣可以顺着这条链路读一读。
小结
Redisson 用「Hash 记录重入次数 + uuid:threadId 标识归属 + Lua 脚本保证原子 + 看门狗自动续期 + pub/sub 唤醒等待线程」这套组合拳,把一把分布式锁需要的功能全部补齐了,这也是它在生产环境中成为默认选择的原因。
3. 主从架构锁失效问题
到这里,Redisson 在单节点上已经足够可靠。但生产环境的 Redis 通常是主从(哨兵)或集群架构,写操作只会落到主节点,再由主节点异步复制给从节点。异步复制意味着主节点宕机时,最近的写操作可能还没有同步到从节点,分布式锁就存在失效的可能。
3.1 失效过程
- 客户端 A 在主节点上执行加锁 Lua 脚本,加锁成功。
- 主节点还没来得及把锁数据同步给从节点,突然宕机。
- 哨兵(或集群)检测到主节点故障,把从节点提升为新的主节点。
- 新主节点上没有这把锁,客户端 B 过来加锁,同样加锁成功。
- 客户端 A 和客户端 B 同时持有同一把锁,互斥性被破坏。
可以看到,问题的根因不是 Redisson 实现得不好,而是 Redis 的复制模型决定的:主从复制是异步的,故障转移会丢掉一部分还没有同步的写操作,锁数据就在其中。
3.2 红锁(RedLock)的原理
针对这个问题,Redis 作者 antirez 提出了 RedLock 算法:不再依赖单个主节点,而是准备 N 个相互独立的 Redis 主节点(官方建议 5 个,不需要从节点和哨兵),客户端依次向它们加锁:
- 记录开始加锁的时间戳。
- 依次向 N 个节点发起加锁请求,每个请求都带相同的 key、value(客户端标识)和过期时间。
- 只有在超过半数(N / 2 + 1,5 个节点就是 3 个)节点上加锁成功,并且总耗时小于锁的有效期,才认为加锁成功。
- 加锁失败时,向所有节点发送释放请求(包括加锁成功的节点),避免残留。
为什么是多数派?因为任意两个客户端不可能同时在超过半数的节点上加锁成功,只要多数节点没有同时丢失数据,就能保证互斥。
Redisson 中对应的实现是 RedissonMultiLock(早期的 RedissonRedLock 在 3.12.0 之后废弃),不过它通常不作为常规生产方案,原因见 3.3 节。
3.3 红锁的缺陷与生产选型
1、原理上的缺陷
RedLock 从提出起就存在争议,分布式系统专家 Martin Kleppmann 在《How to do distributed locking》中提出了质疑,核心观点是:分布式锁的安全性依赖「时钟」,而 RedLock 无法应对 GC 停顿、时钟漂移等情况。
- GC 停顿:客户端 A 加锁成功后发生长时间的 GC,锁在这期间过期;客户端 B 在多数节点上加锁成功。A 从 GC 中醒来后仍然认为自己持有锁,继续操作共享资源,互斥性被破坏。
- 时钟漂移:RedLock 判断「总耗时小于锁有效期」依赖各节点的本地时间,如果节点时钟发生跳变,判断就可能出错。
Martin 给出的解法是 fencing token(栅栏令牌):每次加锁成功都返回一个单调递增的 token,共享资源(如 MySQL)拒绝比已处理过的 token 更小的请求,从而在锁失效时兜底。antirez 则认为 RedLock 已经考虑了这些场景,GC 停顿可以通过合理的续期机制缓解,双方至今也没有争论出统一结论。
2、工程上的代价
就算不谈理论争议,RedLock 的落地成本也很高:
- 需要额外准备 3~5 个相互独立的主节点(官方建议 5 个),不能复用现有的主从、哨兵或集群(复用就失去了「独立」的意义),资源投入和运维成本都很高。
- 每次加锁、解锁都要访问多个节点,网络往返成倍增加,性能比单节点锁差很多;而且任何一个节点抖动都会影响加锁结果,可用性反而下降。
- 节点越多,加锁耗时越容易逼近锁的有效期,高并发下加锁成功率会进一步降低。
3、选型建议
| 方案 | 一致性 | 性能 | 部署成本 | 适用场景 |
|---|---|---|---|---|
| Redisson 普通锁 | 弱,主从切换有丢锁窗口 | 最高 | 低 | 绝大多数业务:缓存更新、定时任务防重复执行等 |
| RedLock | 理论上多数派,但依赖时钟 | 低 | 高,需要额外准备独立节点 | 通常不作为常规方案,理解原理与缺陷即可 |
| ZooKeeper / etcd 锁 | 强,基于共识算法 | 中等 | 中,需要额外维护一套集群 | 资金、库存等一致性要求高的场景 |
一般业务用 Redisson 的普通锁就够了,主从切换导致锁失效的概率本身很低。真正需要强一致的场景,优先选 ZooKeeper、etcd 这类基于共识算法的方案:它们用临时顺序节点 + Watch 实现锁,会话超时后自动释放,不存在主从异步复制丢数据的问题,zxid 单调递增还可以直接当 fencing token 用;相比之下,RedLock 只是把风险分散到了多个节点上。
也可以在主从配置上做文章,例如 min-replicas-to-write(至少要有 N 个从节点在线才接受写请求)、min-replicas-max-lag(从节点延迟不能超过 M 秒),把「丢写」的时间窗口限制住。注意这两个参数只是降低锁失效的概率、缩小丢写窗口,并不能彻底解决锁失效问题,最终仍然要靠业务层的幂等和条件校验兜底。
提示
锁只能降低并发冲突的概率,不能替代业务上的幂等和最终校验。即使锁完全可靠,也建议关键操作(如扣库存)在数据库层加上条件校验(stock >= 1),多一层兜底。
4. 大促场景提升分布式锁的性能
大促(秒杀)场景下,同一个热点商品的请求会瞬间暴涨。如果所有请求都去抢同一把锁,就会全部串行排队:假设单把锁的处理能力是 1 万 QPS,那 10 万 QPS 的请求只能排队等待,大部分请求最终超时失败,用户体验和系统吞吐都很差。
4.1 分段锁(库存分桶)
既然一把锁是瓶颈,那就把一把锁拆成多把锁:把商品库存拆成 N 段,每段对应一个库存 key 和一把锁,然后按一定规则路由到其中某一段,比如请求按用户 ID 取模路由到其中一段。理论上最多可以把锁竞争分散到 N 个分段上,让 N 个请求并行处理,实际效果还取决于分段是否均匀。
以 1000 件库存拆成 10 段为例:
| 分段 | 库存 key | 锁 key | 库存 |
|---|---|---|---|
| 0 | stock:10001:0 | lock:stock:10001:0 | 100 |
| 1 | stock:10001:1 | lock:stock:10001:1 | 100 |
| ... | ... | ... | ... |
| 9 | stock:10001:9 | lock:stock:10001:9 | 100 |
请求按 userId % 10 路由,落到哪一段就扣哪一段的库存:
public class StockService {

    /** 分段数量,按大促峰值并发量评估,一般 10~20 段 */
    private static final int SEGMENT_COUNT = 10;

    @Resource
    private RedissonClient redissonClient;

    @Resource
    private StringRedisTemplate stringRedisTemplate;

    public void deductStock(Long userId) {
        // 1、按用户 ID 取模,把请求分散到不同的分段
        int segment = (int) (userId % SEGMENT_COUNT);
        String stockKey = "stock:10001:" + segment;

        // 2、每段一把锁,锁的粒度从「一个商品」缩小到「一个分段」
        RLock lock = redissonClient.getLock("lock:" + stockKey);
        try {
            lock.lock();
            // 3、扣减该分段的库存
            String stock = stringRedisTemplate.opsForValue().get(stockKey);
            if (stock != null && Integer.parseInt(stock) > 0) {
                stringRedisTemplate.opsForValue().decrement(stockKey);
            }
        } finally {
            lock.unlock();
        }
    }
}
4.2 分段锁的注意点
1、少卖问题
分段之后,库存被拆散,可能出现「某一段扣完了,其他段还有库存」的情况:1000 件库存拆 10 段,如果大部分用户都被路由到第 3 段,第 3 段的 100 件很快扣完,而其他段还有货,用户却提示「已售罄」,造成少卖。
常见的处理思路:
- 某段库存不足时,按顺序尝试其他分段,相当于在库存紧张时回退到串行。
- 每段预留一定 buffer,例如 1000 件库存拆成 11 段、每段 100 件,相当于多准备 100 件作为缓冲。
- 分段锁只负责控制并发,库存仍然放在一个全局 key 上,用 Lua 脚本原子扣减。这样并发度提升,库存也不会被拆散,但扣减本身仍然是串行的。
2、库存汇总
查看商品总库存时,需要把各段库存加起来:
// 统计各分段库存总和
int total = 0;
for (int i = 0; i < SEGMENT_COUNT; i++) {
    String stock = stringRedisTemplate.opsForValue().get("stock:10001:" + i);
    total += stock == null ? 0 : Integer.parseInt(stock);
}
3、分段数量的取舍
- 分段太少,锁竞争依然激烈;分段太多,Redis 的 key 数量、内存和统计成本都会上升,段与段之间库存不均的概率也更大。
- 一般根据大促峰值并发量评估,例如峰值 1 万 QPS、单锁能扛 1000 QPS,就分 10~20 段。
- 分段锁适合「一个商品抢购」这种热点场景,不是所有业务都值得引入。
4.3 其他优化思路
分段锁解决的是「锁竞争」,除此之外还有几个常用的组合拳:
- Lua 脚本原子扣减:把「判断库存 + 扣减」合并成一段 Lua 脚本,一次请求只执行一次脚本,天然原子,性能比加锁更好,甚至可以不使用分布式锁。
- MQ 异步削峰:限流后,把下单请求丢进消息队列,后端按自己的能力匀速消费,把瞬时流量拉平。
- 库存预热:大促开始前把库存加载到 Redis,避免请求直接打到 MySQL。
- 数据库兜底:Redis 扣减成功后异步落库,数据库用
stock >= 1条件更新兜底,防止超卖。