
Redis缓存设计与优化
1. 缓存结构设计
缓存的本质,是用「内存空间」换「访问时间」:把后端存储(通常是 MySQL)里访问慢、访问频繁的数据,提前搬到内存里,让请求在内存这一层就返回,从而减轻数据库压力、降低响应耗时。
但缓存不是万能的,它同时引入了三件事:额外的存储成本、数据一致性成本、架构复杂度。所以设计缓存的第一步,不是选 Redis 的哪种数据结构,而是先想清楚「哪些数据该缓存、用什么读写模式、key 和 value 怎么设计」。
1.1 哪些数据适合放进缓存
| 判断维度 | 适合缓存 | 不适合缓存 |
|---|---|---|
| 读写比例 | 读多写少(二八原则,20% 的数据扛 80% 的访问) | 写多读少 |
| 访问频率 | 热点数据,访问集中 | 低频、长尾数据 |
| 一致性要求 | 能容忍秒级、分钟级的短暂不一致 | 要求强一致(如账户余额、库存扣减后的实时余额) |
| 失效影响 | 缓存失效后有数据库兜底,业务能降级 | 缓存一挂整个业务不可用 |
一句话总结:缓存适合「读多写少 + 热点 + 弱一致」的数据。如果一段数据既要求实时一致、又写多读少,那么加缓存只会徒增复杂度,收益几乎为零。
1.2 缓存读写模式
缓存和数据库之间的读写配合方式,业界主要有四种:
| 模式 | 读操作 | 写操作 | 特点 |
|---|---|---|---|
| Cache Aside(旁路缓存) | 先读缓存,未命中查数据库并回写缓存 | 先更新数据库,再删除缓存 | 最常用,逻辑由业务代码控制,简单灵活 |
| Read Through | 只读缓存,未命中由缓存组件自动回源数据库并回写 | —— | 读逻辑下沉到缓存层,业务代码更简洁 |
| Write Through | 同读 | 写缓存时同步写数据库,两者都成功才返回 | 一致性较好,但写性能受数据库拖累 |
| Write Behind(异步回写) | 同读 | 只写缓存,由缓存组件异步批量刷入数据库 | 写性能最高,但宕机可能丢数据 |
生产环境用得最多的就是 Cache Aside,因为它不依赖缓存组件的特殊能力,普通 Redis + 业务代码就能实现。它的写操作之所以是「删除缓存」而不是「更新缓存」,有两个原因:
- 避免并发写导致的脏数据:两个线程先后更新数据库,如果都去更新缓存,可能旧值后写覆盖新值。
- 懒加载更省资源:更新缓存等于每次都做一次计算/查询,而删除缓存后,如果这个 key 短时间内没被访问,就不必付出重建成本。
至于「先删缓存还是先更新数据库」,属于双写一致性的范畴,后面会详细展开。
1.3 key 设计
key 是缓存的第一道门面,设计得好不好,直接影响可维护性和内存占用。
1、可读性和可管理性
以业务名(或数据库名)为前缀,用冒号分隔,格式为 业务名:表名:id:
trade:order:1这样既避免了不同业务之间的 key 冲突,看 key 就能知道它属于哪块业务,排查问题时非常方便。
2、简洁性
语义清晰的前提下,尽量控制 key 的长度。单个 key 看着不长,但线上往往是几千万、上亿个 key,累积起来的内存开销不容忽视:
user:{uid}:friends:messages:{mid} 简化为 u:{uid}:fr:msg:{mid}3、不要包含特殊字符
强制要求:key 里不要出现空格、换行、单双引号以及其他转义字符。这些字符在客户端序列化、命令行调试、日志打印时都容易出问题。
1.4 value 设计与数据结构选型
1、选择合适的数据类型
同样是存一个用户对象,拆成多个 String 和存成一个 Hash,差别很大:
# 反例:拆成多个 key,字段一多 key 数量爆炸,也不方便整体操作
set user:1:name tom
set user:1:age 19
set user:1:favor football

# 正例:一个 Hash 存一个对象,字段用 field 区分
hmset user:1 name tom age 19 favor football
用 Hash 的好处是:key 数量少、内存更省(Redis 对小 Hash 有 ziplist/listpack 紧凑编码)、可以按字段局部更新。但也要注意,如果对象字段很多、且经常整体读取,hgetall 反而会一次性拉取大量数据,这时候要结合访问模式权衡。
选型的通用思路:
| 需求 | 推荐结构 |
|---|---|
| 缓存单个对象、序列化整存整取 | String(JSON) |
| 对象的局部字段更新、按字段读取 | Hash |
| 时间线、队列、消息列表 | List |
| 去重、标签、共同好友 | Set |
| 排行榜、延迟队列、按分数范围查询 | ZSet |
2、控制 key 的生命周期
Redis 不是垃圾桶,任何写入缓存的数据都应该有明确的过期时间(条件允许时把过期时间打散,避免集中过期):
expire trade:order:1 18001.5 bigkey 的识别、危害与优化
bigkey 是缓存设计中很容易被忽略、但线上杀伤力极大的一个问题。
1、什么是 bigkey
在 Redis 中,一个 String 最大可以到 512MB,一个二级数据结构(Hash、List、Set、ZSet)最多可以放约 40 亿个(2^32 - 1)元素。但实际生产中不会等到这么大,通常满足下面任意一条就认为是 bigkey:
- String 类型:单个 value 超过 10KB。
- 非 String 类型:Hash、List、Set、ZSet 的元素个数太多,一般超过 5000 就算 bigkey。
2、bigkey 的危害
| 危害 | 说明 |
|---|---|
| 阻塞 Redis | Redis 单线程执行命令,操作 bigkey 耗时长,会阻塞后续所有请求 |
| 网络拥塞 | 假设一个 bigkey 是 1MB,客户端每秒访问 1000 次,每秒就是 1000MB 的流量。普通千兆网卡按字节算只有 128MB/s,直接被打满;单机多实例部署时,还会波及其他实例 |
| 过期删除阻塞 | bigkey 设置了过期时间,到期自动删除时也会触发 del。一个 200 万元素的 ZSet 过期删除,可能造成明显阻塞。Redis 4.0 之后可以开启 lazyfree-lazy-expire yes 异步释放 |
3、bigkey 是怎么产生的
一般不是故意为之,而是对数据规模预估不足:
- 社交类:粉丝列表。明星、大 V 的粉丝列表不特殊设计,必然是 bigkey。
- 统计类:按天存储某项功能的用户集合,只要有人在用,集合就会不断膨胀。
- 缓存类:把数据库数据序列化后整个塞进 Redis,常见两个坑——是不是有必要缓存所有字段、有没有把一堆关联数据图省事塞进同一个 key。
4、如何优化
- 拆:big List 拆成
list1、list2……big Hash 可以按范围分段,例如 100 万用户数据拆成 200 个 key,每个 key 放 5000 个,本质是「分段」的思路。 - 按需取:如果 bigkey 不可避免,也要避免每次全量拉取,例如只需要部分字段时用
hmget而不是hgetall。 - 渐进式删除:非 String 的 bigkey 不要直接用
del,用hscan、sscan、zscan分批删除,避免一次性阻塞。
注意
bigkey 的判定不是绝对的。10KB、5000 个元素只是经验阈值,实际要结合你的网络带宽、QPS 和 Redis 部署方式评估。核心原则是:不要让单次操作的数据量和耗时不可控。
1.6 过期策略与内存淘汰
缓存不可能无限增长,Redis 对过期键和内存超限有两套清理机制。
1、过期键的清除
| 策略 | 说明 |
|---|---|
| 惰性删除(被动) | 读/写一个已过期的 key 时才触发删除,冷数据可能长期占内存 |
| 定期删除(主动) | Redis 周期性随机抽查一批设置了过期时间的 key,删除其中已过期的 |
| 内存淘汰 | 已用内存超过 maxmemory 时,按淘汰策略主动清理 |
主从模式下,只有主节点执行过期删除,然后把删除操作同步给从节点,从节点不会自作主张删数据。
2、8 种内存淘汰策略
Redis 4.0 之前有 6 种,4.0 之后又增加了 2 种(LFU 相关),共 8 种:
| 分类 | 策略 | 说明 |
|---|---|---|
| 只处理设置了过期时间的 key | volatile-ttl | 按过期时间先后删除,越早过期越先删 |
volatile-random | 在设置了过期时间的 key 中随机删 | |
volatile-lru | 在设置了过期时间的 key 中按 LRU 淘汰 | |
volatile-lfu | 在设置了过期时间的 key 中按 LFU 淘汰 | |
| 处理所有 key | allkeys-random | 所有 key 随机删 |
allkeys-lru | 所有 key 按 LRU 淘汰 | |
allkeys-lfu | 所有 key 按 LFU 淘汰 | |
| 不处理 | noeviction | 不淘汰任何数据,写入直接报 OOM 错误,只响应读操作 |
3、LRU 与 LFU
- LRU(Least Recently Used,最近最少使用):以「最近一次访问时间」为参考,淘汰很久没被访问的数据。适合存在明显热点、且访问有局部性的场景。
- LFU(Least Frequently Used,最不经常使用):以「最近一段时间被访问的次数」为参考,淘汰访问次数少的数据。
两者的差别在于:LRU 只看「多久没访问」,LFU 还看「访问了多少次」。当存在突发性、周期性的批量操作时,LRU 命中率会急剧下降(缓存污染),这时 LFU 更合适。
策略默认是 noeviction,生产环境推荐 volatile-lru(前提是 key 都设置了过期时间)。另外务必设置 maxmemory,否则 Redis 内存超出物理内存后会开始和磁盘频繁 swap,性能急剧下降。
1.7 命令使用规范
1、O(N) 命令要关注 N 的数量
hgetall、lrange、smembers、zrange、sinter 等并不是不能用,但使用前必须明确 N 的规模。有遍历需求时,用 hscan、sscan、zscan 代替。
2、禁止线上使用危险命令
keys、flushall、flushdb 这类命令在生产环境是灾难级的。可以通过 Redis 的 rename-command 机制把它们重命名成随机字符串,或者直接禁用;需要扫描 key 时用 scan 渐进式处理。
3、合理使用 select 多数据库
Redis 的多数据库能力较弱,用数字区分,很多客户端支持得不好;而且多业务用不同数据库,实际还是同一个单线程处理,会相互干扰。不推荐依赖多数据库做隔离。
4、使用批量操作提高效率
- 原生命令:
mget、mset。 - 非原生命令:
pipeline。
但要注意控制一次批量的元素个数(例如 500 以内,具体和元素字节数有关)。两者的区别:
| 对比项 | 原生命令(mget/mset) | pipeline |
|---|---|---|
| 原子性 | 原子操作 | 非原子操作 |
| 命令类型 | 只能执行同一种命令 | 可以打包不同的命令 |
| 支持条件 | 服务端原生支持 | 需要客户端和服务端同时支持 |
5、Redis 事务功能较弱,可以用 Lua 替代
Redis 的事务不支持回滚,遇到运行时错误依然会继续执行后续命令。需要「判断 + 操作」原子化的场景(如分布式锁释放、库存扣减),优先用 Lua 脚本。
1.8 客户端使用规范
1、避免多个应用共用一个 Redis 实例
不相干的业务尽量拆分,公共数据做服务化,避免一个业务的慢操作拖垮另一个业务。
2、使用带连接池的客户端(Spring Boot 配置)
Spring Boot 通过 spring-boot-starter-data-redis 自动配置 Redis 客户端,默认使用 Lettuce。要开启连接池,必须额外引入 commons-pool2,否则 lettuce.pool 下的配置不会生效(Lettuce 默认共享一个长连接,本身不依赖连接池;只有引入池化依赖后才会按配置维护连接)。
<!-- Spring Boot 3.x:Redis starter,默认使用 Lettuce -->
<dependency>
    <groupId>org.springframework.boot</groupId>
    <artifactId>spring-boot-starter-data-redis</artifactId>
</dependency>

<!-- Lettuce 连接池依赖,不引入则 pool 配置不生效 -->
<dependency>
    <groupId>org.apache.commons</groupId>
    <artifactId>commons-pool2</artifactId>
</dependency>
application.yml 中配置连接与连接池:
spring:
  data:
    redis:
      host: 192.168.1.21
      port: 6379
      password: 123456
      database: 0
      # 命令读写超时
      timeout: 3000ms
      # 建立连接超时
      connect-timeout: 3000ms
      lettuce:
        pool:
          # 最大连接数
          max-active: 50
          # 最大空闲连接数
          max-idle: 10
          # 最小空闲连接数
          min-idle: 5
          # 连接耗尽时获取连接的最大等待时间,-1 表示永不超时
          max-wait: 1000ms
        shutdown-timeout: 100ms
注意
Spring Boot 2.x 的配置前缀是 spring.redis.*,Spring Boot 3.x 改成了 spring.data.redis.*,升级时不要写错,否则配置会被静默忽略。
连接池参数含义与建议:
| Spring Boot 配置 | 含义 | 默认值 | 建议 |
|---|---|---|---|
lettuce.pool.max-active | 资源池中最大连接数 | 8 | 按 QPS 估算,见下文 |
lettuce.pool.max-idle | 允许的最大空闲连接数 | 8 | 建议等于理论连接数 |
lettuce.pool.min-idle | 至少保持的空闲连接数 | 0 | 可配合预热使用 |
lettuce.pool.max-wait | 获取连接的最大等待时间 | -1,永不超时 | 不建议用默认值,避免无限等待 |
redis.timeout | 命令读写超时 | —— | 结合接口耗时设置,避免慢命令拖死线程 |
max-active 怎么估算:假设一次命令(获取连接 + 执行命令含网络)平均耗时约 1ms,单个连接的 QPS 约 1000;业务期望 QPS 是 50000,那么理论上需要 50000 / 1000 = 50 个连接。实际要比理论值再预留一些,所以 max-active 可以适当放大。
但绝不是越大越好:连接太多会占用客户端和服务端资源,而且对于 Redis 这种高 QPS 服务,一个阻塞的大命令带来的延迟,再大的连接池也救不了。max-idle 才是业务真正需要的最大连接数,max-active 是留余量,最佳性能是 max-active = max-idle,避免连接池频繁伸缩。
使用方式:自动配置会提供 StringRedisTemplate 和 RedisTemplate<Object, Object>,直接注入即可。字符串场景用 StringRedisTemplate,缓存对象时,RedisTemplate 默认用 JDK 序列化,写进 Redis 的是二进制乱码、可读性差,建议自定义序列化:key 用 String,value 用 JSON。
连接池预热:如果系统启动后马上就有大量请求,可以在启动完成后先执行一次简单命令,触发连接建立与健康检查,避免冷启动时集中建连。配合 min-idle,池中会保持一定数量的空闲连接:
@Component
public class RedisWarmUp implements ApplicationRunner {

    @Resource
    private RedisConnectionFactory connectionFactory;

    @Override
    public void run(ApplicationArguments args) {
        // 执行一次 ping,触发连接建立
        try (RedisConnection connection = connectionFactory.getConnection()) {
            connection.ping();
        }
    }
}
3、其他建议
- 高并发下客户端建议增加熔断功能(如 Sentinel、Hystrix),避免 Redis 抖动拖垮应用。
- 设置合理的密码,如有必要使用 SSL 加密访问。
1.9 系统内核参数与慢查询
1、vm.swappiness
Linux 不一定要把物理内存用满才会使用 swap,swappiness 决定操作系统使用 swap 的倾向程度,取值 0~100,值越大越倾向于用 swap,越小越倾向于用物理内存。对于高并发、高吞吐的 Redis 来说,磁盘 IO 是瓶颈,要尽量避免 swap:
cat /proc/version                    # 查看 Linux 内核版本
echo 1 > /proc/sys/vm/swappiness     # 内核 >= 3.5 建议设为 1
echo vm.swappiness=1 >> /etc/sysctl.conf
内核 < 3.5 建议设为 0,内核 >= 3.5 建议设为 1。这样系统宁可 swap,也不会触发 OOM killer 把 Redis 进程杀掉。
PS:OOM killer 机制是指 Linux 发现可用内存不足时,强制杀死一些用户进程(非内核进程),以保证系统有足够内存分配。
2、vm.overcommit_memory(默认 0)
| 取值 | 含义 |
|---|---|
| 0 | 内核会检查是否有足够的可用物理内存,不够就拒绝申请 |
| 1 | 内核允许分配所有物理内存,不管当前内存状态 |
Redis 建议设置为 1,这样 fork 操作在低内存下也能执行成功(否则 RDB 备份、AOF 重写时的 fork 可能因申请不到内存而失败):
cat /proc/sys/vm/overcommit_memory
echo "vm.overcommit_memory=1" >> /etc/sysctl.conf
sysctl vm.overcommit_memory=1
3、合理设置文件句柄数
进程打开的句柄数达到上限后,继续打开会报 Too many open files。Redis 作为网络服务,需要大量文件描述符:
ulimit -a          # 查看系统文件句柄数,看 open files 那项
ulimit -n 65535    # 设置系统文件句柄数
4、慢查询日志 slowlog
config get slow*                                   # 查询慢日志配置
config set slowlog-log-slower-than 20000           # 阈值,单位微秒,此处 20 毫秒
config set slowlog-max-len 1024                    # 慢日志最多保存条数
config rewrite                                     # 保存到 redis.conf
slowlog len                                        # 当前慢查询日志长度
slowlog get 5                                      # 获取最新 5 条慢查询
slowlog reset                                      # 重置慢查询日志
生产环境建议把阈值设为 1000(1 毫秒),因为理论上 Redis 并发至少能到 1000;如果要求单机并发上万,可以设为 100。慢日志记录时会对长命令做截断,不会占用大量内存,条数可以适当设大,避免丢失。
2. 缓存穿透
2.1 什么是缓存穿透
缓存穿透指的是:查询一个根本不存在的数据,缓存层和存储层都不会命中。通常出于容错考虑,从存储层查不到数据就不会写入缓存,于是这个「空结果」每次请求都要穿透缓存,直接打到存储层。
缓存穿透会导致不存在的数据每次请求都要访问数据库,彻底失去了缓存保护后端存储的意义。造成穿透的原因主要有两个:
- 业务代码或数据问题:比如参数校验缺失,传了一个不可能存在的 ID。
- 恶意攻击、爬虫:短时间内构造大量不存在的 key 发起请求,造成大量空命中。
2.2 缓存空对象
最简单的方案:即使数据库查不到数据,也把这个「空结果」缓存起来,并设置一个较短的过期时间。
public String get(String key) {
    // 1、先查缓存
    String cacheValue = redis.get(key);
    if (cacheValue != null) {
        // 注意:空对象缓存的可能是 "",需要和真正没命中区分开
        return StringUtils.isBlank(cacheValue) ? null : cacheValue;
    }

    // 2、查数据库
    String storageValue = loadFromDb(key);
    // 3、无论是否有值都写入缓存
    redis.set(key, storageValue);
    // 4、数据库也没查到,设置较短的过期时间(如 5 分钟),避免长期占用内存
    if (storageValue == null) {
        redis.expire(key, 60 * 5);
        return null;
    }
    return storageValue;
}优点:实现简单,一次写入就能挡住后续重复的空查询。
缺点:
- 空结果会占用缓存空间;如果攻击者随机生成大量不存在的 key,缓存里会堆积大量空对象,可能把正常数据挤出去。所以空对象的 TTL 一定要短。
- 存在数据不一致窗口:如果某条数据后来在数据库里被创建了,但缓存里还留着空对象,在 TTL 到期前会一直读到「不存在」。所以写数据时要记得清掉对应的空对象缓存。
2.3 布隆过滤器
对于恶意攻击造成的大量空命中,缓存空对象只能事后兜底,而布隆过滤器可以在请求进入缓存之前就把它挡掉。
1、原理
布隆过滤器由「一个大型位数组 + 几个不同的无偏 hash 函数」组成。所谓无偏,就是 hash 结果分布均匀。
- 添加元素:用多个 hash 函数对 key 求值,得到多个位置,把位数组上这些位置都置为 1。
- 判断元素:同样算出这些位置,只要有一个位是 0,说明这个 key 一定不存在;如果全是 1,说明这个 key 可能存在(这些位可能被其他 key 置 1 了)。
所以有一句经典结论:布隆过滤器说存在,不一定存在;说不存在,那就肯定不存在。
2、特点
| 特点 | 说明 |
|---|---|
| 空间效率高 | 用位数组存储,占用空间远小于保存原始数据 |
| 存在误判 | 判断「存在」时可能误判,「不存在」时一定准确 |
| 不支持删除 | 把某个位置 0 会影响其他 key,要删除只能重建整个过滤器 |
| 需要预热 | 所有数据必须提前写入过滤器,新增数据也要同步写入 |
因为「不支持删除 + 需要预热」,布隆过滤器适合数据相对固定、实时性要求低、数据集较大的场景。
3、Redisson 实现
引入依赖:
<dependency>
    <groupId>org.redisson</groupId>
    <artifactId>redisson-spring-boot-starter</artifactId>
    <version>3.52.0</version>
</dependency>
初始化过滤器并预热数据:
@Resource
private RedissonClient redissonClient;

private RBloomFilter<String> bloomFilter;

@PostConstruct
public void init() {
    bloomFilter = redissonClient.getBloomFilter("nameList");
    // 初始化:预计元素 1 亿个,误差率 3%,底层位数组大小由这两个参数算出
    bloomFilter.tryInit(100_000_000L, 0.03);
    // 把所有已存在的数据提前放入过滤器
    for (String key : loadAllKeys()) {
        bloomFilter.add(key);
    }
}
查询时用它做第一层拦截:
public String get(String key) {
    // 1、布隆过滤器判断:不存在就直接返回,不再往后走
    if (!bloomFilter.contains(key)) {
        return null;
    }
    // 2、布隆过滤器认为存在,走正常的缓存 + 数据库流程
    String cacheValue = redis.get(key);
    if (cacheValue != null) {
        return cacheValue;
    }
    String storageValue = loadFromDb(key);
    if (storageValue == null) {
        // 误判:确实不存在,缓存空对象兜底
        redis.setex(key, 60, "");
        return null;
    }
    redis.setex(key, 1800, storageValue);
    return storageValue;
}
注意
布隆过滤器不能删除数据。如果业务数据会删除,只能定期重建过滤器;或者改用支持删除的变种(如 Counting Bloom Filter)。因此它更适合「只增不删」或「删除后允许短暂误判」的场景。
2.4 其他兜底手段与选型
除了空对象和布隆过滤器,还有几层「事前」的防护:
- 参数校验:在接口入口就校验参数合法性,比如 ID 必须是正整数、长度不能超过阈值、格式必须匹配。非法参数直接拒绝,根本不用到缓存。
- 限流:对同一 IP、同一用户、同一接口做频率限制,挡住爬虫和恶意刷量。
- 白名单:对已知合法数据建立白名单,只放行白名单内的查询。
选型对比:
| 方案 | 拦截位置 | 能否实时更新 | 额外存储 | 适用场景 |
|---|---|---|---|---|
| 缓存空对象 | 缓存层 | 能(TTL 到期或主动删) | 缓存空间 | 通用兜底,配合其他方案使用 |
| 布隆过滤器 | 缓存之前 | 增可以,删不行 | 位数组小 | 数据相对固定、防恶意攻击 |
| 参数校验/限流/白名单 | 最外层 | 能 | 无 | 所有场景的基础防线 |
实践中通常是组合使用:参数校验 + 限流挡住大部分恶意流量,布隆过滤器过滤不存在的 key,缓存空对象兜底布隆过滤器的误判。
3. 缓存击穿
3.1 什么是缓存击穿
缓存击穿指的是:某个热点 key 在失效的瞬间,大量并发请求同时未命中缓存,全部打到数据库。
典型场景是一个热门商品的详情页,key 的 TTL 到期,正好赶上流量高峰,成百上千个线程同时发现缓存为空,然后一起去查数据库、一起回写缓存。数据库瞬时压力骤增,如果重建缓存本身又比较慢(复杂 SQL、多次 IO、依赖多个服务),就很容易把数据库打挂。
击穿的本质是同一个热点 key 被大量线程重复重建,所以下面的方案都围绕「只让一个线程去重建」展开。
3.2 方案一:互斥锁重建
最直接的思路:使用分布式锁只允许一个线程去重建缓存,其他线程等待,重建完成后重新读缓存,生产环境直接上 Redisson,用 lock() 阻塞加锁一步到位:
@Resource
private RedissonClient redissonClient;

public String get(String key) {
    String cacheValue = redis.get(key);
    if (cacheValue != null) {
        return cacheValue;
    }

    RLock lock = redissonClient.getLock("lock:rebuild:" + key);
    // 阻塞加锁:只允许一个线程重建,其余线程在这里等待
    lock.lock();
    try {
        // 双重检查:可能已有其他线程重建完成
        cacheValue = redis.get(key);
        if (cacheValue != null) {
            return cacheValue;
        }
        cacheValue = loadFromDb(key);
        // 回写缓存,过期时间加随机值,避免与其他 key 集中失效
        redis.setex(key, 1800 + new Random().nextInt(300), cacheValue);
        return cacheValue;
    } finally {
        if (lock.isLocked() && lock.isHeldByCurrentThread()) {
            lock.unlock();
        }
    }
}互斥锁方案的优缺点:
- 优点:实现简单,能保证同一时刻只有一个线程重建,数据库压力可控;而且
lock()不指定租期时会启动看门狗自动续期(默认 30 秒、每 10 秒续一次),重建耗时再久也不会丢锁。 - 缺点:所有线程都要等待,重建期间接口响应时间变长;只要持有者不释放锁,其他线程就会一直阻塞等待,重建很慢或失败时等待线程会大量堆积,在大促这类高并发场景下是隐患,后面会专门优化。
3.3 方案二:逻辑过期
互斥锁的问题是「读线程要等」。如果我们允许请求读到旧数据,就可以把等待完全消除:key 本身不设置 TTL(永久有效),而是在 value 内部记录一个「逻辑过期时间」。请求发现逻辑过期后,只由拿到锁的线程异步重建,其他线程直接返回旧值。
先把 value 包一层,带上逻辑过期时间:
public class CacheData<T> {
    /** 真正的业务数据 */
    private T data;
    /** 逻辑过期时间戳(毫秒) */
    private Long expireTime;

    public CacheData(T data, Long expireTime) {
        this.data = data;
        this.expireTime = expireTime;
    }
    // getter、setter 省略
}
再实现读取逻辑:
private final ExecutorService rebuildPool = Executors.newFixedThreadPool(10);

public String get(String key) {
    // 1、从 Redis 取数据(key 本身不过期)
    CacheData<String> cacheData = getFromRedis(key);
    if (cacheData == null) {
        return null;
    }
    // 2、还没到逻辑过期时间,直接返回
    if (cacheData.getExpireTime() > System.currentTimeMillis()) {
        return cacheData.getData();
    }
    // 3、已逻辑过期:只让一个线程异步重建,其余请求继续返回旧值
    RLock lock = redissonClient.getLock("lock:rebuild:" + key);
    if (lock.tryLock()) {
        rebuildPool.submit(() -> {
            try {
                String dbValue = loadFromDb(key);
                CacheData<String> newData = new CacheData<>(
                        dbValue, System.currentTimeMillis() + 30 * 60 * 1000);
                setToRedis(key, newData);
            } finally {
                lock.unlock();
            }
        });
    }
    // 4、无论是否抢到锁,都先返回旧值,保证接口快速响应
    return cacheData.getData();
}这种做法在电商大促、热点新闻等「能接受短暂脏数据、但绝不能慢/挂」的场景非常实用:请求永远不会因为重建而阻塞,数据库也不会被打穿。
代价是要额外处理两件事:
- 数据同步:逻辑过期意味着缓存可能长期返回旧数据,需要有后台任务或消息通知,在数据变更时主动刷新。
- 内存:key 永不过期,只靠逻辑时间控制,需要有兜底的清理机制,防止冷数据永远占着内存。
3.4 方案三:热点 key 永不过期 + 后台刷新
这是逻辑过期的一个简化变体:对识别出来的热点 key,不设置 TTL,改由一个后台定时任务周期性刷新缓存,保证数据始终是「新鲜」的。
这种方式实现最简单,适合热点 key 相对固定、且能接受一定刷新延迟的场景。缺点也很明显:热点是动态变化的,需要一套热点探测机制;后台任务的刷新频率也要权衡,太频繁浪费资源,太稀疏数据又不新鲜。
3.5 方案对比与选型
| 方案 | 是否阻塞请求 | 数据新鲜度 | 实现复杂度 | 适用场景 |
|---|---|---|---|---|
| 互斥锁重建 | 会等待重建完成 | 高,重建后立即返回新值 | 低 | 大多数缓存场景,读一致性要求较高 |
| 逻辑过期 | 不阻塞,返回旧值 | 偏低,有刷新延迟 | 中 | 大促、热点新闻等「宁可旧不可慢」场景 |
| 永不过期 + 后台刷新 | 不阻塞 | 取决于刷新频率 | 中 | 热点固定、刷新频率可预估的场景 |
选型的核心判断是:「读请求能不能接受旧数据」。能接受,就用逻辑过期,用旧值换响应速度和可用性;不能接受,就用互斥锁,用等待换取一致性。
4. 缓存雪崩
缓存雪崩指的是:缓存层支撑不住或挂掉后,流量像奔逃的野牛一样,全部打向后端存储层。
缓存层本来承载着大量请求,有效地保护了存储层。但一旦缓存层因为某些原因无法提供服务——比如超大并发导致缓存层扛不住、大量请求访问 bigkey 导致缓存并发能力急剧下降、或者大批 key 在同一时间集中失效——大量请求就会直接打到存储层,存储层的调用量暴增,造成级联宕机。
除了大批 key 集中过期,还有一类更严重的情况:缓存集群本身宕机。
可以从以下几个方向预防和解决:
- TTL 打散:批量写入缓存时,把过期时间加上一个随机值,避免同一时间大面积失效。例如原本统一 300 秒过期,改成 300~600 秒之间的随机数。
- 缓存层高可用:使用 Redis Sentinel 或 Redis Cluster,避免单点故障导致整个缓存层不可用。
- 限流、熔断、降级:依赖隔离组件(如 Sentinel、Hystrix)为后端限流熔断。比如服务降级时,非核心数据(商品属性、用户信息)直接返回预定义的默认值、空值或错误提示;核心数据(商品库存)仍允许查缓存和数据库。
- 缓存预热:系统上线或大促开始前,提前把热点数据加载进缓存,避免上线瞬间缓存为空。
- 提前演练:项目上线前演练缓存宕掉后的应用与后端负载情况,据此做一些预案设定。
其中「多级缓存」是抵御缓存雪崩、尤其是缓存层整体抖动时非常有效的一招,单独展开。
4.1 多级缓存架构解决线上缓存雪崩
传统方案是「应用 → Redis → MySQL」,Redis 一旦抖动或大面积失效,请求就会毫无缓冲地砸向 MySQL。多级缓存的核心思想是:在请求到达 Redis 之前,再加一层离应用更近的缓存,把流量逐层过滤掉。
一个典型的多级缓存架构是:
请求 → Nginx / OpenResty 本地缓存 → JVM 进程内缓存(Caffeine)→ Redis → MySQL各层的特点:
| 层级 | 典型实现 | 访问速度 | 容量 | 数据实时性 | 作用 |
|---|---|---|---|---|---|
| 接入层缓存 | Nginx、OpenResty(Lua + shared dict) | 极快 | 小 | 低 | 在网关层挡住静态、热点资源 |
| 进程内缓存 | Caffeine、Guava Cache | 快(无网络) | 小 | 中 | 挡住单机热点,减少 Redis 访问 |
| 分布式缓存 | Redis | 中等(一次网络往返) | 大 | 高 | 跨实例共享的主缓存 |
| 数据库 | MySQL | 慢 | 最大 | 最高 | 最终数据源 |
以 Java 应用为例,引入 Caffeine 作为进程内缓存:
@Bean
public Cache<String, String> localCache() {
    return Caffeine.newBuilder()
            // 最多缓存 1 万个 key,按访问频率淘汰
            .maximumSize(10_000)
            // 写入 10 分钟后失效,作为兜底
            .expireAfterWrite(10, TimeUnit.MINUTES)
            .build();
}
读取时层层回源,并逐层回填:
public String get(String key) {
    // 1、先查 JVM 进程内缓存
    String value = localCache.getIfPresent(key);
    if (value != null) {
        return value;
    }
    // 2、再查 Redis
    value = redis.get(key);
    if (value != null) {
        localCache.put(key, value);
        return value;
    }
    // 3、最后才查数据库
    value = loadFromDb(key);
    if (value != null) {
        redis.setex(key, 1800, value);
        localCache.put(key, value);
    }
    return value;
}
这样即使 Redis 整体宕机,本地缓存仍然能挡住一部分热点请求,不至于让流量全部落到 MySQL。
不过多级缓存也引入了新的问题,落地时要重点处理:
- 本地缓存一致性:数据在 A 实例被更新后,B 实例的本地缓存还是旧值。常见做法是通过 Redis 的发布订阅或 MQ 广播失效消息,各实例收到后删除本地缓存。
// 数据变更时,广播本地缓存失效消息,各实例监听后删除本地 key
redis.publish("cache:invalidate", key);- 本地缓存容量与淘汰:进程内缓存吃的是应用内存,容量必须严格限制(如 Caffeine 的
maximumSize),并设置兜底过期时间,防止冷数据堆积拖垮应用。 - 热点探测:不是所有数据都值得放本地缓存,通常只把识别出来的热点数据放进去,否则每个实例都缓存全量数据,内存吃不消。
- 复杂度与收益的权衡:多级缓存会显著增加系统复杂度(数据同步、失效广播、监控),只有在对性能和可用性要求极高的核心链路上才值得引入。
小结
多级缓存的本质是把「单点缓存」变成「多层漏斗」:一层的失效不会让流量直接穿透到数据库。它解决的是缓存雪崩中「缓存层整体不可用」这类最严重的场景,属于「用复杂度换可用性」的重武器。
4.2 其他常规手段
除了多级缓存,前面提到的几种手段落地时也有一些细节:
1、TTL 打散
// 基础过期时间 300 秒,再加一个 0~300 秒的随机值
int expireTime = 300 + new Random().nextInt(300);
redis.setex(key, expireTime, value);注意打散要在批量写入时做,不要只给单个 key 加随机值,否则意义不大。同时给 key 加上过期时间本身也是一种保护——即使某一时刻数据不一致,过期后也会自动恢复。
2、缓存层高可用
用 Sentinel 或 Cluster 消除单点)。但要注意,高可用解决的是「节点故障」,解决不了「大批 key 同时过期」和「bigkey 拖垮缓存」,这两者仍然要靠 TTL 打散和数据结构优化。
3、限流熔断降级
在应用和数据库之间加一道限流,超出的请求快速失败或走降级逻辑。降级要按数据重要程度区分:
// 伪代码:非核心数据降级,核心数据放行
if (isCoreData(key)) {
    return getFromCacheOrDb(key);
} else {
    return getDegradeValue(key); // 返回默认值 / 空值 / 缓存中的旧值
}
4、缓存预热
系统启动或大促开始前,通过定时任务或手动脚本把热点数据加载到 Redis,避免「冷启动」时缓存为空,请求全部涌向数据库。
4.3 缓存穿透、击穿、雪崩的辨析
到这里,缓存穿透、缓存击穿、缓存雪崩这三个最容易混淆的问题就都讲完了,用一个表统一总结:
| 问题 | 触发原因 | 波及范围 | 核心应对 |
|---|---|---|---|
| 缓存穿透 | 查询的是根本不存在的数据 | 单个/多个不存在的 key | 缓存空对象、布隆过滤器 |
| 缓存击穿 | 热点 key 恰好失效 | 某一个热点 key | 互斥锁重建、逻辑过期 |
| 缓存雪崩 | 大批 key 同时失效,或缓存集群宕机 | 大面积 key 或整个缓存层 | TTL 打散、高可用、多级缓存、熔断降级 |
一句话记忆:穿透是「查的压根不存在」,击穿是「热点 + 单个 key + 失效瞬间」,雪崩是「一大片同时倒下」。
5. 数据库与缓存双写不一致
5.1 不一致是怎么产生的
在大并发下,同时操作数据库和缓存,会出现数据不一致。主要有两类:
1、双写不一致
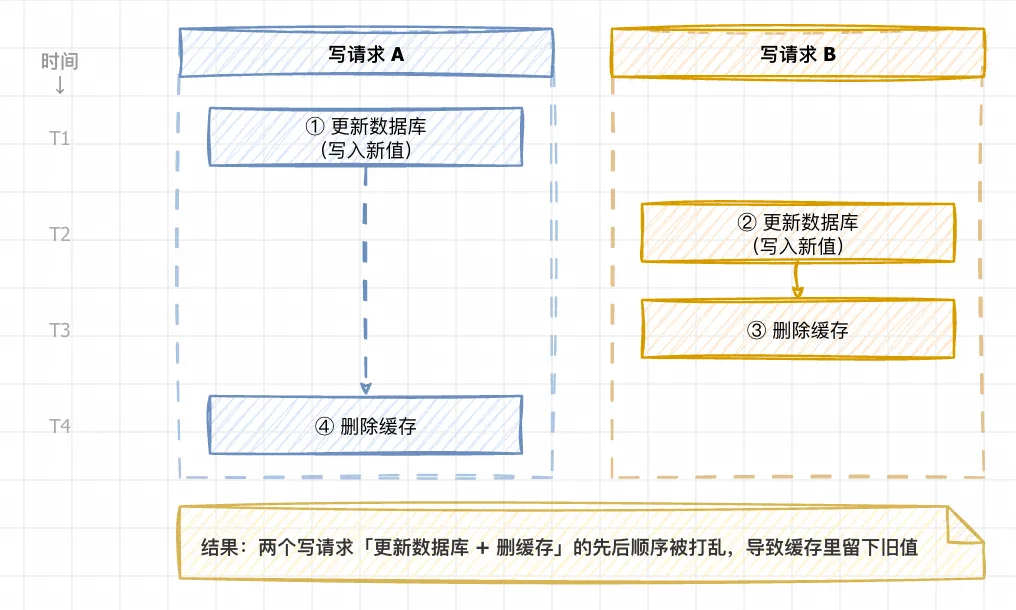
两个写请求并发,一个更新数据库 + 删缓存,另一个也在更新,操作的先后顺序被打乱,导致缓存里留下旧值。
2、读写并发不一致
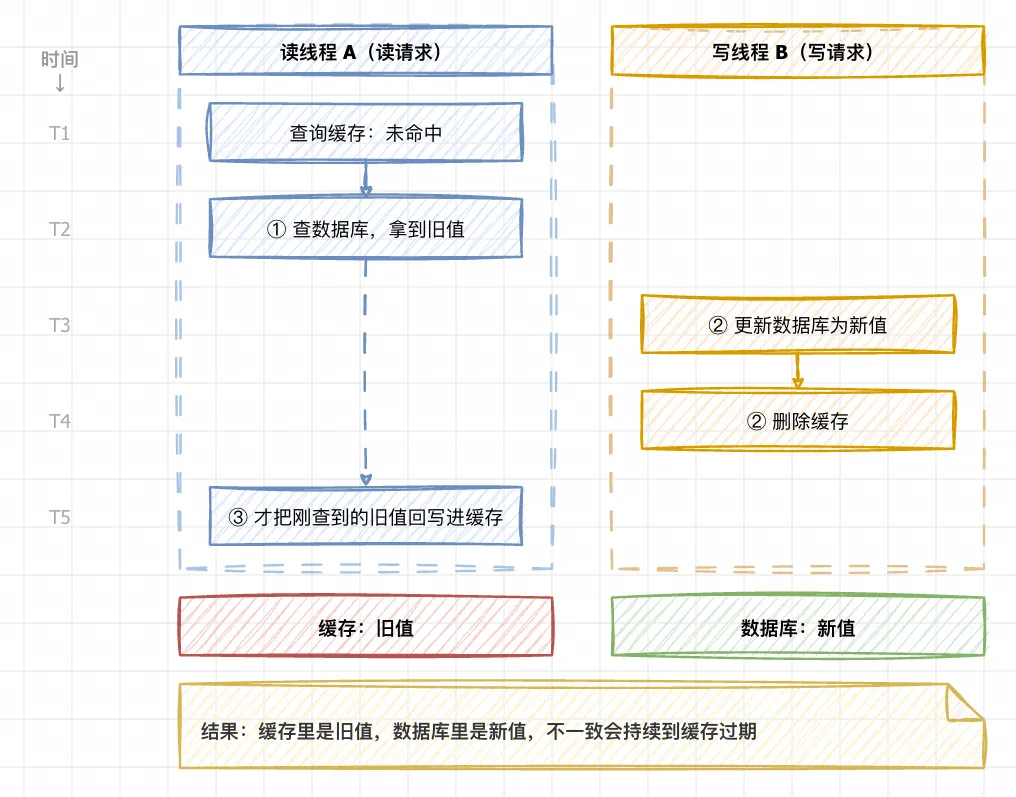
一个读请求未命中缓存,去查数据库;与此同时另一个写请求更新数据库并删除缓存。可能出现的时序是:
- 读线程 A 查数据库,拿到旧值。
- 写线程 B 更新数据库为新值,并删除缓存。
- 读线程 A 才把刚查到的旧值回写进缓存。
结果缓存里是旧值,数据库里是新值,不一致持续到缓存过期。
5.2 先删缓存还是先更库
Cache Aside 模式下,「删缓存」和「更库」的先后顺序决定了不一致窗口的大小:
| 顺序 | 可能出现的问题 |
|---|---|
| 先删缓存,再更库 | 删完缓存还没更库时,读请求进来未命中,查到旧值并回写;随后写线程更库为新值,缓存里却还是旧值 |
| 先更库,再删缓存 | 更库成功、删缓存失败(或删之前服务宕机),缓存里会一直留旧值;但这种情况概率较低,且可被过期时间兜底 |
推荐「先更新数据库,再删除缓存」。因为第二种顺序的不一致,只有在「读请求刚好在删缓存前查询、且回写发生在删除之后」这种较罕见的时序下才会出现;而删除失败还可以通过重试、过期时间兜底。这也是大部分互联网公司的选择。
5.3 延迟双删
为了进一步缩小「先删缓存再更库」的不一致窗口,可以在更新数据库前后各删一次缓存,中间等待一小段时间,也就是「延迟双删」:
public void update(Long id, String value) {
    String key = "product:detail:" + id;
    // 1、先删一次缓存
    redis.del(key);
    // 2、更新数据库
    updateDb(id, value);
    // 3、延迟一段时间,让可能存在的旧值回写操作先完成,再删一次
    scheduledExecutor.schedule(() -> redis.del(key), 500, TimeUnit.MILLISECONDS);
}
延迟的时间需要根据「读请求查库 + 回写缓存」的耗时来估算,太短了旧值还没回写,太长了不一致窗口又被拉长。延迟双删能降低不一致概率,但不能完全杜绝,仍然依赖过期时间兜底。
5.4 分布式读写锁
如果业务真的不能容忍缓存不一致,可以在读写时加分布式读写锁,保证并发读写、写写按顺序执行,而读读之间不加锁、并行执行。Redisson 提供了 RReadWriteLock:
RReadWriteLock rwLock = redissonClient.getReadWriteLock("product:rw:" + id);

// 读:读读不互斥,多个线程可同时持有读锁
rwLock.readLock().lock();
try {
    // 读缓存 / 数据库
} finally {
    rwLock.readLock().unlock();
}

// 写:读写、写写互斥
rwLock.writeLock().lock();
try {
    // 更新数据库 + 删除缓存
} finally {
    rwLock.writeLock().unlock();
}读写锁能从机制上保证一致性,但代价是读操作也要加锁,性能下降、依赖 Redis 可用性,只适合一致性要求高且并发量可控的场景。
5.5 canal 订阅 binlog
另一种思路是不靠业务代码双写,而是让缓存变更完全由数据库驱动:用阿里开源的 canal 伪装成 MySQL 的从节点,订阅 binlog 日志,数据库一有变更就异步通知应用去更新/删除缓存。
好处是业务代码不用关心缓存,完全解耦,缓存最终会和数据库一致。缺点是引入了新的中间件(canal + MQ),系统复杂度上升,并且是最终一致,存在同步延迟。
5.6 选型与结论
| 方案 | 一致性 | 性能 | 复杂度 | 适用场景 |
|---|---|---|---|---|
| 过期时间兜底 | 最终一致 | 高 | 低 | 并发低、能容忍短暂不一致 |
| 先更库再删缓存 | 最终一致 | 高 | 低 | 大多数场景的默认选择 |
| 延迟双删 | 最终一致(概率更高) | 较高 | 中 | 对不一致较敏感的场景 |
| 分布式读写锁 | 强 | 低 | 中 | 强一致、并发可控 |
| canal 订阅 binlog | 最终一致 | 高 | 高 | 不想让业务代码侵入缓存逻辑 |
最后要强调一个原则:放入缓存的数据,本来就应该是实时性、一致性要求不高的数据。切记不要为了用缓存,同时又要求绝对一致,而做大量的过度设计和控制——那样只会增加系统复杂度。
如果数据确实「写多读多」又「不能容忍不一致」,那其实没必要加缓存,直接操作数据库即可。当然,如果数据库抗不住压力,还可以反过来:把缓存作为数据读写的主存储,异步把数据同步到数据库,数据库只作为备份。
6. 大促分布式锁串行争用优化实战
前面讲缓存击穿时,我们用互斥锁(lock() 阻塞)让「只有一个线程重建缓存」。这一节把它放到大促的高并发查询场景里,具体讨论锁怎么用才不拖垮接口。
注意:这里的锁用于读 / 查询场景,和 Redis 分布式锁 里秒杀扣库存用的分段锁(写场景)目的不同,实现细节也不一样,不要混淆。
6.1 大促查询场景下的锁串行问题
大促时,某个热点商品详情、热点活动页的查询 QPS 可能瞬间涨到平时的几十倍。如果这个热点 key 恰好过期,就会发生前面说的缓存击穿:
- 如果不加锁:所有线程都去查数据库,热点查询把数据库打满。
- 如果加互斥锁但让其他线程原地重试/自旋:大量线程阻塞在锁上,CPU 空转,而且重建没完成前谁也拿不到结果。
- 如果用
lock()无限等待、不做超时控制:一旦重建线程执行慢,后面所有线程都被长时间挂起,接口大面积超时。
所以大促查询场景下,锁的关键不在「加不加」,而在「等多久、等不到怎么办」。
6.2 tryLock 超时等待 + 双重检查
针对查询场景,推荐的做法是 tryLock(waitTime, leaseTime, unit) + 二次检查缓存:
- 只让第一个拿到锁的线程去查数据库、重建缓存。
- 其余线程带着一个有限的等待时间去
tryLock,在这个窗口内等待锁释放,而不是无限阻塞或疯狂自旋。 - 拿到锁之后,先做双重检查:因为等待期间缓存很可能已经被重建好了,此时直接读缓存返回,根本不需要再查数据库。
tryLock等待超时(说明重建异常地慢),走降级逻辑,避免请求全部积压。
waitTime 怎么定?按接口的预估耗时来定。比如预估这个查询接口重建缓存最多 5 秒能完成,就把等待时间设为 5 秒:
public String queryHotProduct(Long productId) {
    String key = "product:detail:" + productId;

    // 1、先读缓存,命中直接返回
    String cacheValue = redis.get(key);
    if (cacheValue != null) {
        return cacheValue;
    }

    RLock lock = redissonClient.getLock("lock:query:" + key);
    try {
        // 2、按接口预估耗时设置等待时间:预估 5 秒内能重建完成
        //    waitTime = 5s  :其他线程最多等 5 秒
        //    leaseTime = 10s:即使持有者宕机,锁也会自动释放,不会死锁
        if (lock.tryLock(5, 10, TimeUnit.SECONDS)) {
            try {
                // 3、双重检查:等待期间缓存可能已经被前面的线程重建好了
                cacheValue = redis.get(key);
                if (cacheValue != null) {
                    return cacheValue;
                }
                // 4、确实还没重建好,才查数据库并回写缓存
                cacheValue = loadFromDb(productId);
                redis.setex(key, 1800 + new Random().nextInt(300), cacheValue);
                return cacheValue;
            } finally {
                if (lock.isLocked() && lock.isHeldByCurrentThread()) {
                    lock.unlock();
                }
            }
        }
        // 5、等待超时(重建太慢):降级返回兜底数据,而不是继续压数据库
        return fallback(productId);
    } catch (InterruptedException e) {
        Thread.currentThread().interrupt();
        return fallback(productId);
    }
}
整个流程可以概括为:
- 线程 A 抢到锁,查数据库、写缓存、释放锁。
- 线程 B、C、D…… 调用
tryLock(5s)进入等待,被 Redis 的释放消息唤醒。 - 锁释放后,等待的线程中有一个拿到锁,但它做双重检查时发现缓存已经有了,于是直接读缓存返回、立即释放锁。
- 后面的线程同理,全部命中缓存,没有一个线程真正去查数据库。
这样既保证了「同一时刻只有一个线程重建」,又不会让等待的线程做无用功——等待的代价只是短暂的阻塞,而不是一次次穿到数据库。
为什么等待时间要用「超时」而不是无限等?
大促场景追求的是「快速失败、就近降级」。如果重建真的出了异常(数据库慢查询、下游超时),无限等待会让线程池被占满,最终拖垮整个应用。设置 5 秒等待,是给绝大多数正常请求留出重建窗口,同时给异常情况设一个止损点。
6.3 与分段锁、缓存击穿互斥锁的关系
| 场景 | 手段 | 目的 | 是否读缓存 |
|---|---|---|---|
| 缓存击穿 | 互斥锁重建(lock() 阻塞) | 避免热点 key 失效时大量线程查库 | 重建后读缓存 |
| 大促热点查询(本节) | tryLock 超时等待 + 双重检查 | 在保证只重建一次的前提下,让等待线程尽快从缓存拿数据 | 等待期间/拿锁后都优先读缓存 |
| 秒杀扣库存(04 文件) | 分段锁 + Lua 原子扣减 | 拆散写锁竞争,提升扣减并发度 | 不涉及 |
三者的共同点是都用分布式锁控制并发,区别在于:击穿锁追求「只重建一次」,大促查询锁在此之上还要兼顾「等待线程的响应时间」,而分段锁解决的是写操作的锁竞争。
6.4 配套手段
锁只是大促查询优化的一环,通常还要配合下面几招:
- 逻辑过期 / 本地缓存:对极致热点,用逻辑过期或多级缓存,让请求根本不走到锁这一步。
- MQ 削峰:把非实时性的写请求(下单)异步化,前端只做限流和预校验,后端匀速消费,削平瞬时流量。
- 缓存预热:大促开始前把商品、活动等热点数据提前加载进 Redis,避免开场瞬间缓存为空。
- 数据库兜底:即使缓存和锁都失效,数据库层也要有条件校验(如
stock >= 1),保证数据最终正确。